Jev发布:RLHF之父Diogo Almeida新作,开创“校准决策强化学习”(RLCD)时代
SmartHey9月22日消息,据雷锋网报道,近日,全网热议新模型 Jev——推特上多位技术领袖用它通关《超级马里奥》、过滤垃圾信息、执行加密货币交易策略,并称其为“Agent 时代的系统1”;也有观点认为,它本质是一个高度优化的结构化决策引擎。
Jev 是由 ChatGPT 早期核心开发者、RLHF(基于人类反馈的强化学习)提出者 Diogo Almeida 创立 TypeSafe AI 后,潜心研发两年推出的首项成果。与传统大语言模型显著不同的是:Jev 不生成自然语言文本,而是专精于结构化决策。
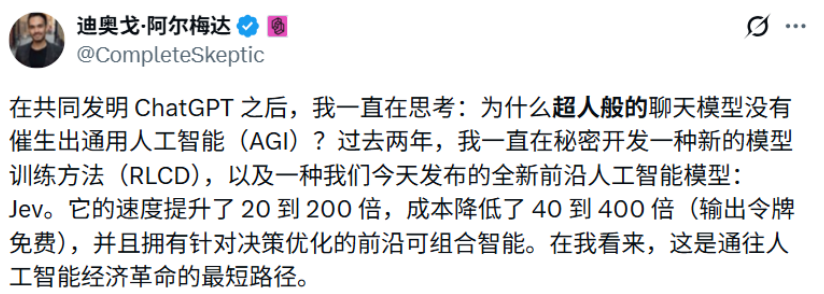
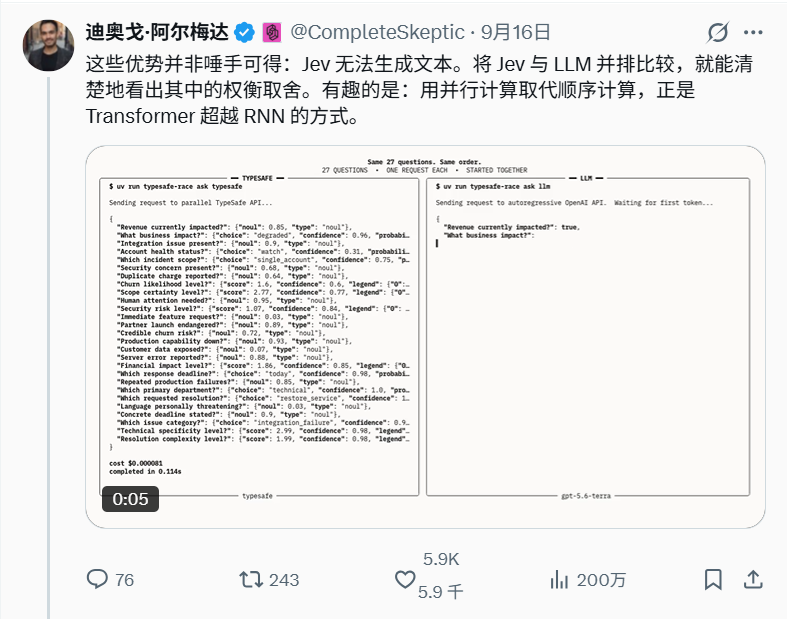
它接收非结构化输入(如网页内容、日志片段、用户指令等),直接输出带明确语义类型的概率化决策结果——代码可无缝调用该结果触发后续动作。简言之,Jev 是一个“可编程判断中枢”,输入任意信息,输出确定性指令。其能力严格限定于三类原语操作:bool(二元判断)、choice(多选项择优)、score(量化评分)。
因此,Jev 的核心优势在于“极速”与“极省”。官网数据显示,其推理速度达主流 LLM 的 20–200 倍,单位决策成本降低近两个数量级,且所有输出 Token 免费。这一性能跃升,源于全新模型架构、高效并行采样器,以及首创训练范式——校准决策强化学习(RLCD)。
值得注意的是,RLCD 的提出,正源于 Diogo Almeida 对 RLHF 的深度反思。当年,为使 GPT-3 等仅擅长文本接龙的模型贴合人类表达偏好,RLHF 应运而生,并成为 ChatGPT 成功的关键基石。
然而,随着 RLHF 在工业界大规模部署,其依赖主观人类评分的局限日益凸显:面对专业性强、答案模糊或人类本身难以评判的复杂任务时,模型易产生“讨好式幻觉”,即强行编造看似合理实则错误的回答。
为此,可验证奖励强化学习(RLVR)兴起——借助编译器、形式化验证器或数学证明系统提供客观对错反馈,推动 OpenAI o1/o3、DeepSeek-R1 等模型进入“深度推理时代”。但代价是响应延迟高、计算开销大,难以满足企业高频自动化场景中“毫秒级响应+高置信度决策”的真实需求。
RLCD 正是在此背景下诞生。Diogo Almeida 指出:盲目扩大模型规模、依赖长链思维链(Chain-of-Thought)打草稿,并不适用于实时工业决策。RLCD 的核心理念是——要求模型仅输出其“认知边界内可校准的概率答案”:有七成把握就说七成,绝不外推、不虚构、不妥协准确率换流畅度。
因此,Jev 在设计上彻底规避幻觉风险。它摒弃逐字生成模式,改用并行采样机制,在内部同步评估大量候选决策路径,并于 70ms–500ms 内输出标准化结构化结果。在 System One 类封闭型决策任务(如规则匹配、流程路由、合规审查)中,其表现已媲美 GPT-5.6 Terra 等前沿闭源模型。