单人+AI智能体3.5个月训出代码大模型!Mirendil打破百人预训练范式
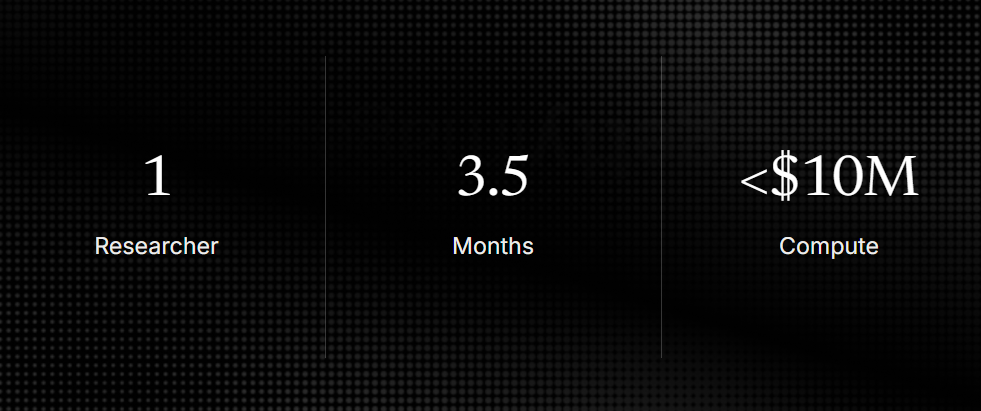
SmartHey10月23日消息,北京时间10月22日,硅谷前沿AI实验室Mirendil发布突破性研究成果:仅由一名研究员协同AI智能体,耗时3.5个月、算力投入不足1000万美元,即从零完成代码专用基础模型Mirendil‑Base的全流程预训练。该成果挑战了业界长期共识——‘高性能基础模型必须依赖百人级专业团队与超大规模算力集群’。
传统大模型预训练是典型重人力工程:需架构设计、数据清洗、分布式训练运维、CUDA内核优化等多领域专职工程师紧密协作,头部机构常动用数万至数十万颗AI芯片。而Mirendil此次实验聚焦极限验证——AI智能体能否替代绝大多数人类工程角色,支撑端到端的大规模预训练闭环。
项目全程从空白代码仓库启动,仅基于PyTorch、JAX等通用开源框架开发;训练数据全部取自GitHub公开仓库与合法爬取的网页文本,未采购任何授权数据集,亦未采用模型蒸馏或合成数据增强。超过99%的代码编写、超参调优、日志分析、故障定位与重试决策均由AI智能体自主完成;人类研究员仅负责设定研究目标、关键节点审核、结果可信性验证及战略级决策干预。
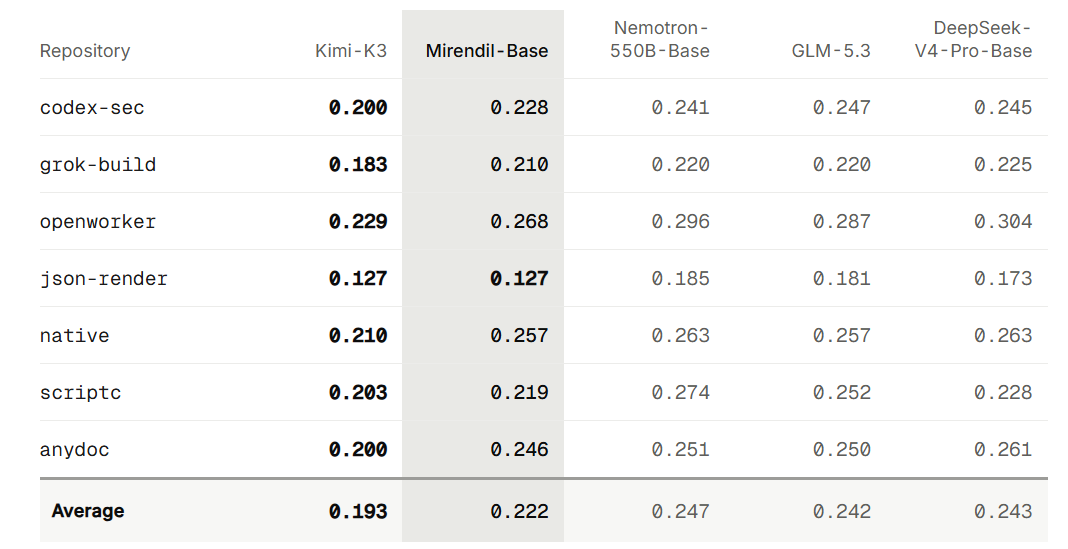
评测表明,Mirendil‑Base在代码补全与生成任务中表现优异:在7个完全未参与训练的外部开源代码库测试集上,其平均性能指标仅次于Kimi‑K3,超越Nemotron‑550B‑Base、GLM‑5.3、DeepSeek‑V4‑Pro‑Base等主流MoE架构基座模型。
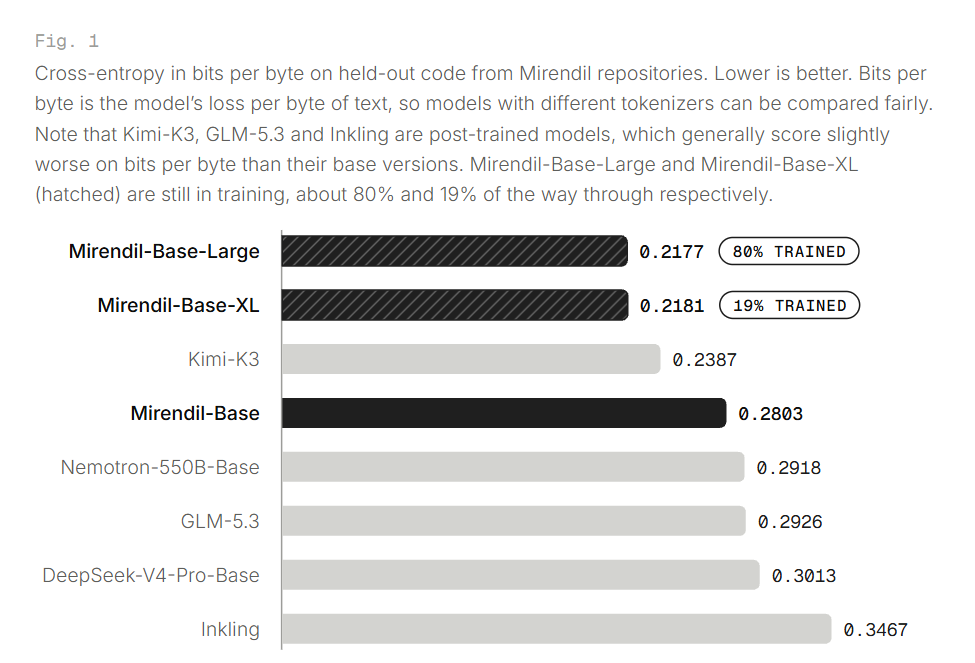
Mirendil同步披露,同系列更大规模模型进展顺利:Mirendil‑Base‑Large已完成80%预训练,Mirendil‑Base‑XL完成19%,当前收敛曲线显示性能随参数量扩展呈现稳定正相关,符合理论预期。
实验室指出,这一实验标志着AI研发瓶颈正在发生结构性迁移:过去制约创新的核心是稀缺的专业人力,未来则将转向算力可及性、高质量领域数据沉淀,以及研究者对问题本质的判断力与方向把控力。这意味着高门槛的前沿预训练能力正加速走向普惠化。
芯片设计、机器人控制、生物医药等垂直领域团队,即便不具备大模型训练经验,未来也可依托自有代码/实验数据,低成本训练专属基础模型,不再局限于对通用大模型进行浅层微调。
该范式更催生新型科研组织形态:团队扩张不再依赖线性增员,而是通过算力杠杆放大个体研究员效能——小规模团队即可发起过去仅头部科技公司才能承担的复杂AI研发项目。研究员的核心价值,也将从重复性工程执行(如写脚本、跑实验、修报错),跃升为实验架构设计、技术路径权衡、算力资源动态规划等高阶科研决策。
需要说明的是,Mirendil‑Base尚未实现完全自主递归迭代,尚不构成闭环式自我改进系统,但“AI辅助AI研发”的正向飞轮已清晰可见,距离全自动科研助手仅差关键几步。
下一步,Mirendil将启动Mirendil‑Base的后训练对齐(Alignment)工作,并持续公开Large与XL版本的训练进度。该实验室长期使命是降低前沿AI研发门槛,推动大模型深度赋能药物发现、新材料模拟、具身智能等硬科技领域的科学探索进程。