跨维智能发布全球首个3D原生世界模型UNITAS,统一建模动作与世界变化
SmartHey10月13日消息,10月12日,跨维智能(DexForce)正式发布全球首个面向具身操作的机器人任务原生3D世界模型UNITAS(A 3D-Native World Action Model for Embodied Manipulation),为Physical AI构建统一三维物理表示空间迈出关键一步。
UNITAS的核心主张是:唯有让模型从底层原生理解三维物理世界,世界模型才能真正逼近“世界”本身。
那么,如何让机器人在真实三维环境中理解“动作”与“状态变化”?当机器人真正走进物理世界,它面临的不仅是“下一步该做什么”,更是“这个动作将如何改变世界”。
传统机器人策略模型聚焦于“选择最优动作”,而世界模型则致力于“预测动作引发的环境演化”。过去,这两类问题常被割裂建模;但UNITAS指出,在真实物理过程中,动作执行与世界响应本是一体两面、不可分割的同一事件。
以“伸手拿起杯子”为例:机械臂的运动轨迹是动作,杯子脱离桌面并发生位移则是结果——二者共同构成一次完整的物理交互。若机器人仅学习“如何动”,却无法推演“动后世界如何变”,便难以真正掌握物理规律与因果逻辑。
UNITAS的突破正在于此:将视觉观察、具身动作与环境演化,全部映射并联合建模于同一个三维物理坐标系中。
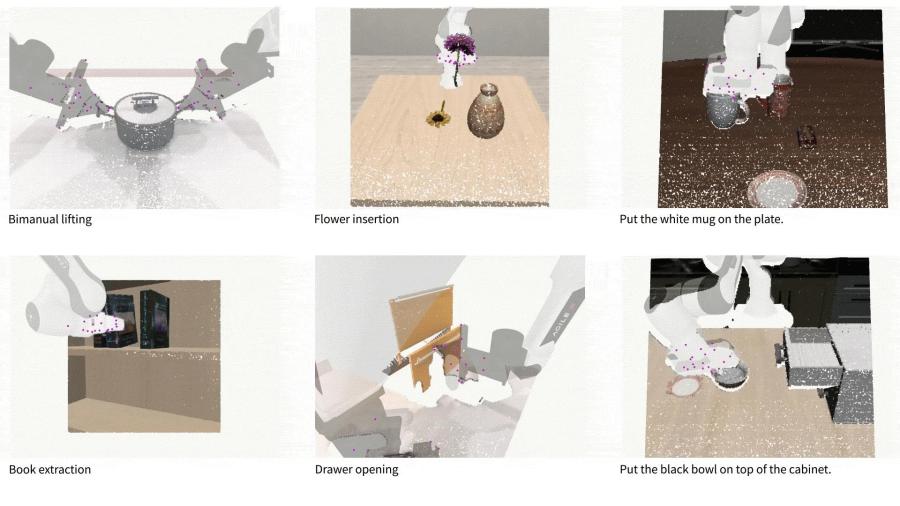
或许有人会问:当前已有多种方法引入三维信息。但UNITAS的“3D原生”(3D-Native)并非简单叠加深度或点云,而是让模型直接在统一三维空间中学习——世界表征以三维点云Token为基本单元,无需依赖图像Token作为中间桥梁。
例如,在执行“拿起杯子”任务时,模型不仅要定位杯子、规划夹爪路径,还需实时建模:夹爪接近时杯子受力形变、抓取瞬间的微小滑移、抬起过程中桌面反作用力对整体场景的影响等动态响应。
UNITAS通过双流三维轨迹建模实现这一目标:一是动作流(Action Flow),刻画人手或夹爪关键点随时间的空间轨迹;二是场景流(Scene Flow),以动作流为条件,预测杯子、桌面、周围物体等场景要素的协同运动。所有过程均在同一三维坐标系下端到端联合优化,使模型既能根据目标生成可执行动作,也能依据动作前向推演未来世界状态。
实验证明,UNITAS展现出卓越性能:仅采用1.7B(17亿)参数规模,在主流机器人操作评测基准中全面领先——LIBERO平均成功率高达99.8%,LIBERO-Plus达89.1%;在RoboTwin 2.0双臂操作任务中,Clean与Randomized设置下分别取得92.94%和93.04%成功率,显著超越参数量达6B的Fast-WAM、8B的Motus,以及π0.5、LingBot-VA、PointWorld等前沿模型;在真实机器人平台部署后,任务平均成功率达85%,验证了其强泛化性与工程落地潜力。