Pika发布开源音视频联合生成模型H3 Flex:6步去噪、多模态输入、支持音频分轨与本地/云端协同创作
SmartHey11月2日消息,近日,Pika正式发布基于MiniMax H3的开源衍生模型——Pika H3 Flex,并同步开放适配器权重与完整推理代码。该模型创新采用六步去噪联合建模机制,可同步生成高质量画面与立体声音频,支持文本提示、首尾帧约束及多模态参考输入,为创作者提供镜头设计、参考引导生成和精细化视频编辑等全流程能力。
本次发布包含两套轻量级LoRA适配器:一套专用于文本+首尾帧条件下的可控生成,另一套面向图像、视频片段、音频等多种参考信号的多模态生成任务。同时配套提供MiniMax H3基础组件与本地推理工具链。模型原生支持480P与768P分辨率输出,单次生成时长约为5至15秒的音视频内容。
Pika已集成ComfyUI工作流并支持Hugging Face Diffusers标准接口,便于开发者快速接入现有AI创作平台。除本地部署外,Pika还提供云端API服务,支持1080P、2K乃至4K分辨率增强渲染,以及专业级音频分轨功能——原始同步生成的声音可自动拆解为对白、配乐、音效、拟音与环境声五条独立音轨,满足影视后期精细化调音需求。高分辨率增强与分轨处理均由Pika API后台完成,实现“低耗草稿筛选 + 高质终版精修”的高效协作流程。
据Pika技术博客披露,研发团队首先在自建音视频配对数据集上对MiniMax H3进行监督微调;随后引入投影分布匹配蒸馏(PDMD)技术,将教师模型原本需50步完成的去噪过程压缩至仅6步,显著提升生成效率而不损质量。
在此基础上,团队进一步采用奖励反馈学习(RFL)与直接偏好优化(DPO)方法训练LoRA适配器,重点提升生成结果的美学表现力、画面清晰度与指令遵循准确性。适配器在推理阶段直接合并至主干模型,全程无需额外增加采样步数。
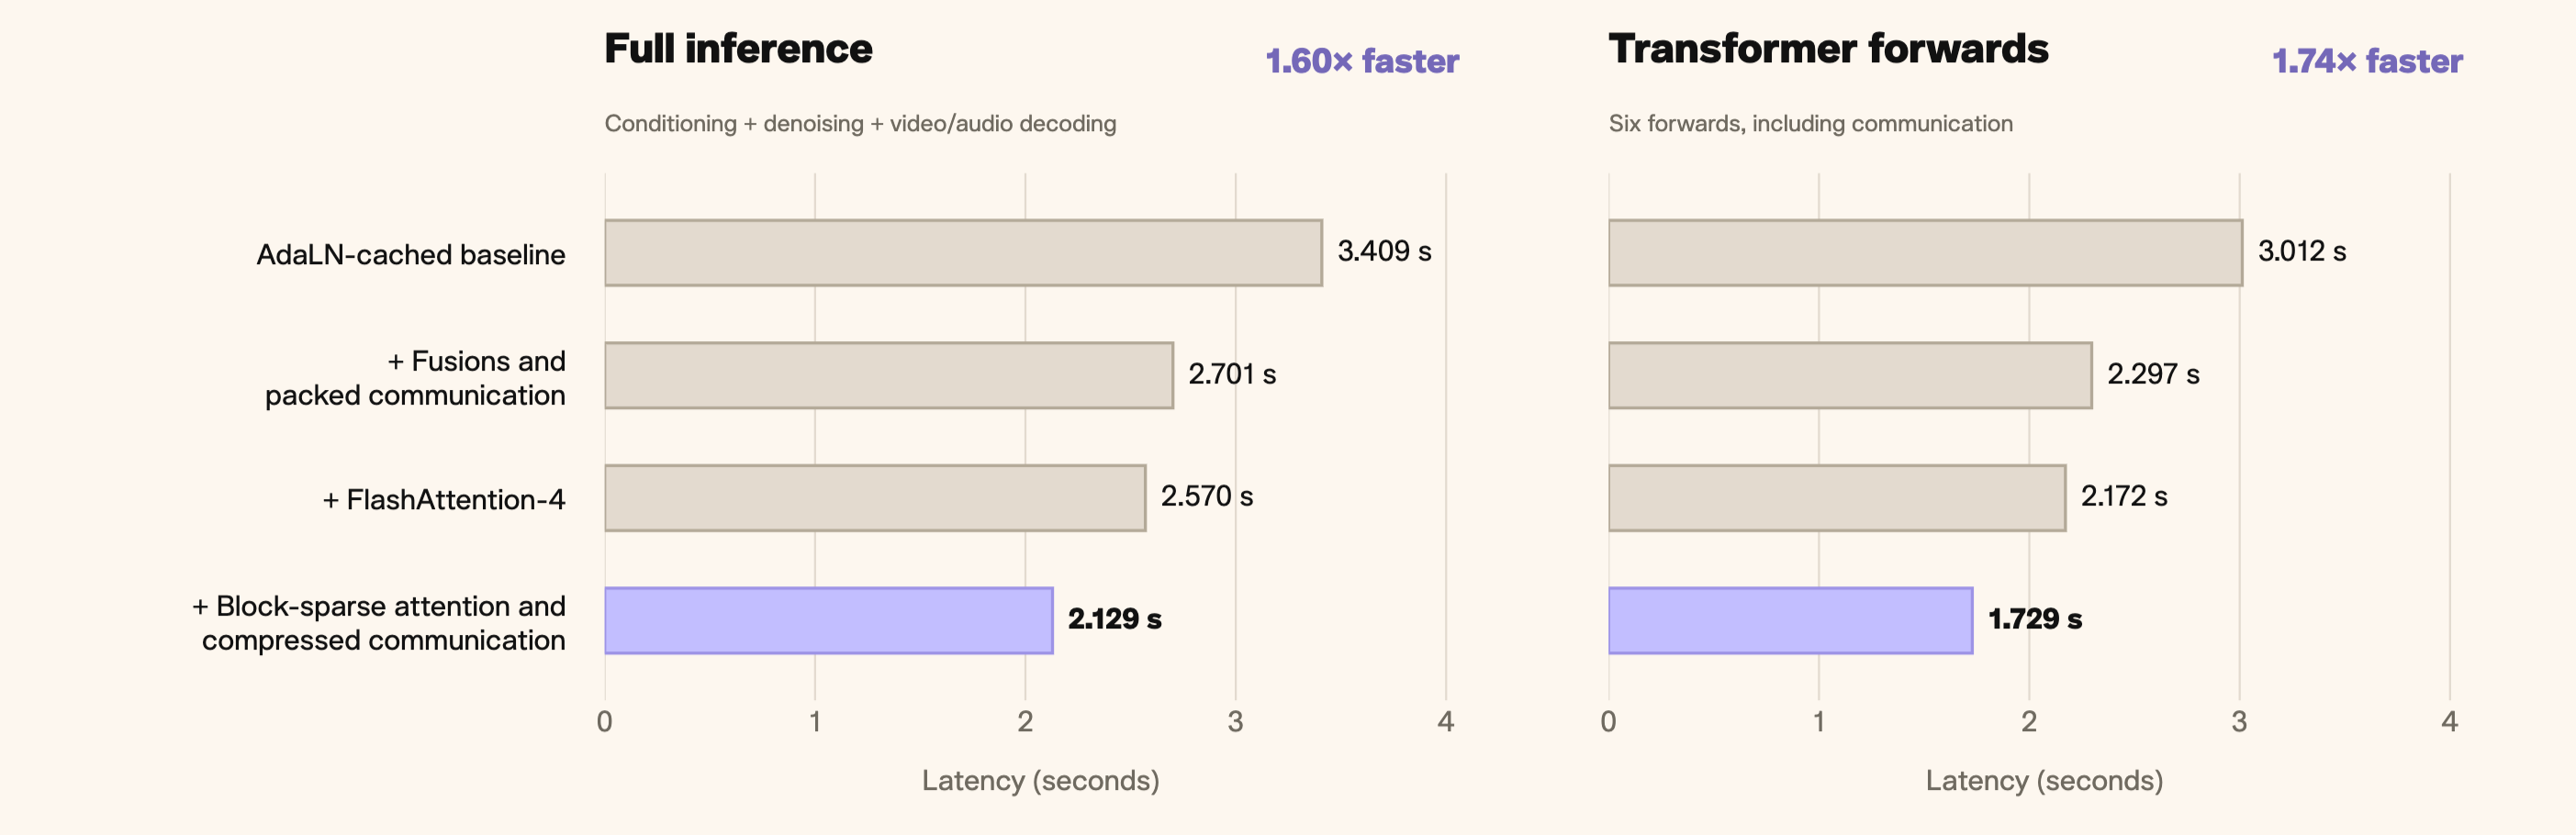
Pika还对托管推理服务进行了深度加速优化。在保持模型权重与六步采样策略不变的前提下,使用8张NVIDIA B300 GPU处理一段5秒、768P音视频时,条件编码、去噪与解码全流程耗时由3.409秒降至2.129秒,整体吞吐效率提升约1.6倍。
在权威评测中,H3 Flex于五项核心视觉与音频质量指标(含运动连贯性、纹理真实感、声画同步度、信噪比与动态范围)均位居参评模型首位,并在DesignArena文生视频基准榜单中位列第八,是当前该榜单中排名最高的开源视频生成模型。
自今年8月MiniMax H3开源以来,其生态已迅速扩展:Running Hub推出H3 480P轻量版;fal聚焦实时生成场景,发布H3 Max 768P与H3 Max 480P;FastVideo通过稀疏化与硬件协同优化推出FastH3;英伟达联合MIT开发StreamRender-H3与Open-H3-Regenerate-2K等前沿变体。海外开发者更基于H3构建出Twitch AI直播插件、“24小时AI电视台”及短视频AI直播应用等创新实践。
上线仅一个月,MiniMax H3全球下载量突破2400万次,催生超300个公开衍生模型,成为2026年全球下载量最高的AI基础模型之一。