卡帕西提出LLM使用四梯队模型:仅5000人能接触最前沿AI系统
SmartHey10月13日消息,前OpenAI、特斯拉AI负责人安德烈·卡帕西(Andrej Karpathy)近日在社交平台发文指出,当前全球仅有约5000人可直接访问最前沿的内部AI系统,而约60亿人几乎从未与大语言模型(LLM)有过实质性交互。
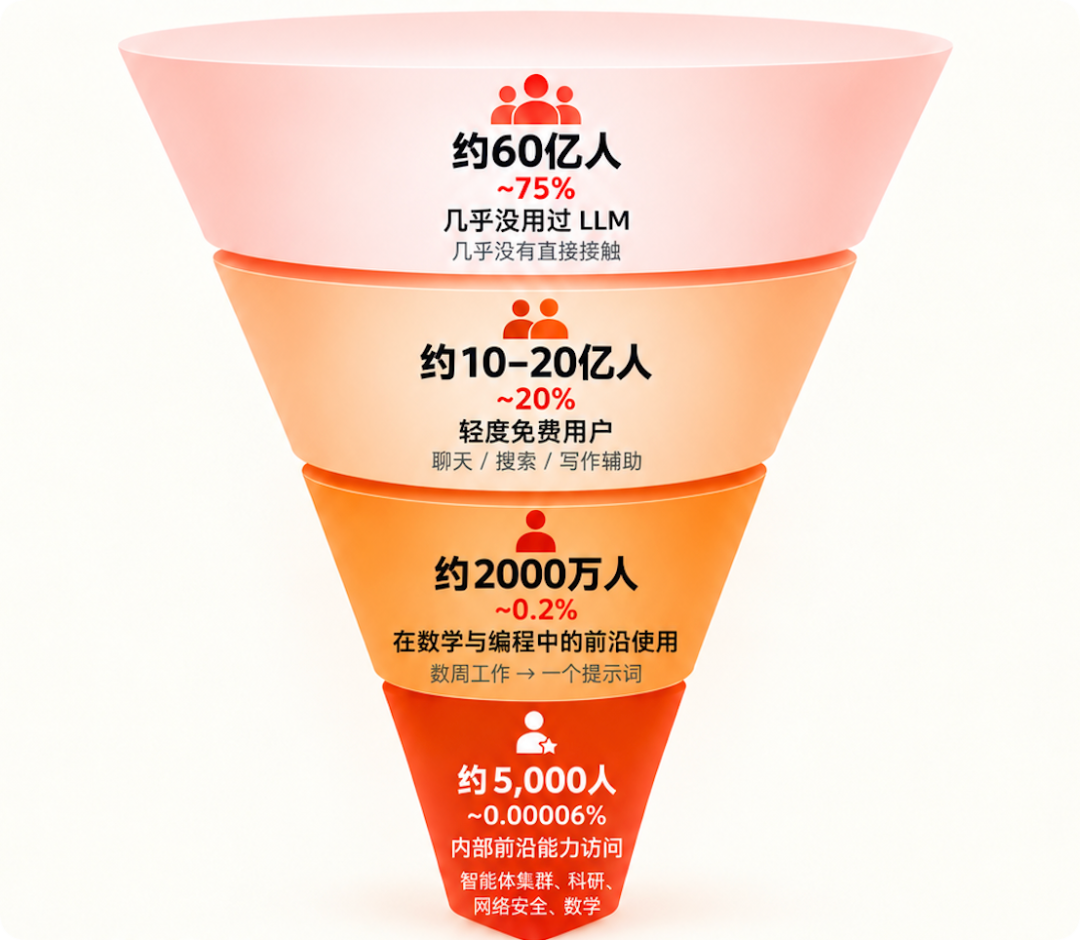
卡帕西将人类对LLM的实际使用深度与认知水平划分为四个层级,各层级人数呈断崖式递减,相应带来的技术体验与价值感知也存在显著差异。
第一层(约60亿人,占比约75%):尚未真正使用过LLM,对人工智能的理解主要来自媒体报道或影视作品中的科幻设定。
第二层(约10亿—20亿人,占比约20%):偶尔使用ChatGPT等免费公开模型,多将其视为“升级版搜索引擎”或“反应略慢的对话助手”。
第三层(约2000万人,占比约0.2%):集中在数学、编程等强逻辑领域,已开始借助AI Agent完成原本需数周人力投入的复杂任务。
第四层(约5000人,占比仅0.00006%):可直接调用实验室级前沿AI系统,支持数千智能体协同运行数周,应用于网络攻防推演、零日漏洞挖掘等高难度真实场景。
卡帕西进一步阐释了这种体验鸿沟的成因。
关键在于:唯有面对规模庞大、结构复杂且具备长期规划需求(Long-horizon)的真实难题时,顶尖LLM的深层能力才能被充分激活。
现实中,多数人初次接触AI的方式往往非常轻量——比如解释一个术语、生成节日祝福语,或概括一篇短文。这类任务虽便捷高效,却难以触发用户对技术范式变革的直观震撼;对模型而言,也因任务过于简单而无法展现其推理深度与系统性协作潜力。
这就像开着一辆高性能跑车,只在狭小停车场内反复挪动,便断言‘它不过如此’——真正的性能,需要开阔道路与持续挑战来验证。
另一重要因素是:LLM的能力突破最先发生在纯数字化、结果可验证、且具备明确经济价值的领域,例如代码生成与数学证明。这些场景为模型提供了清晰反馈闭环和快速迭代基础,从而加速能力跃迁。