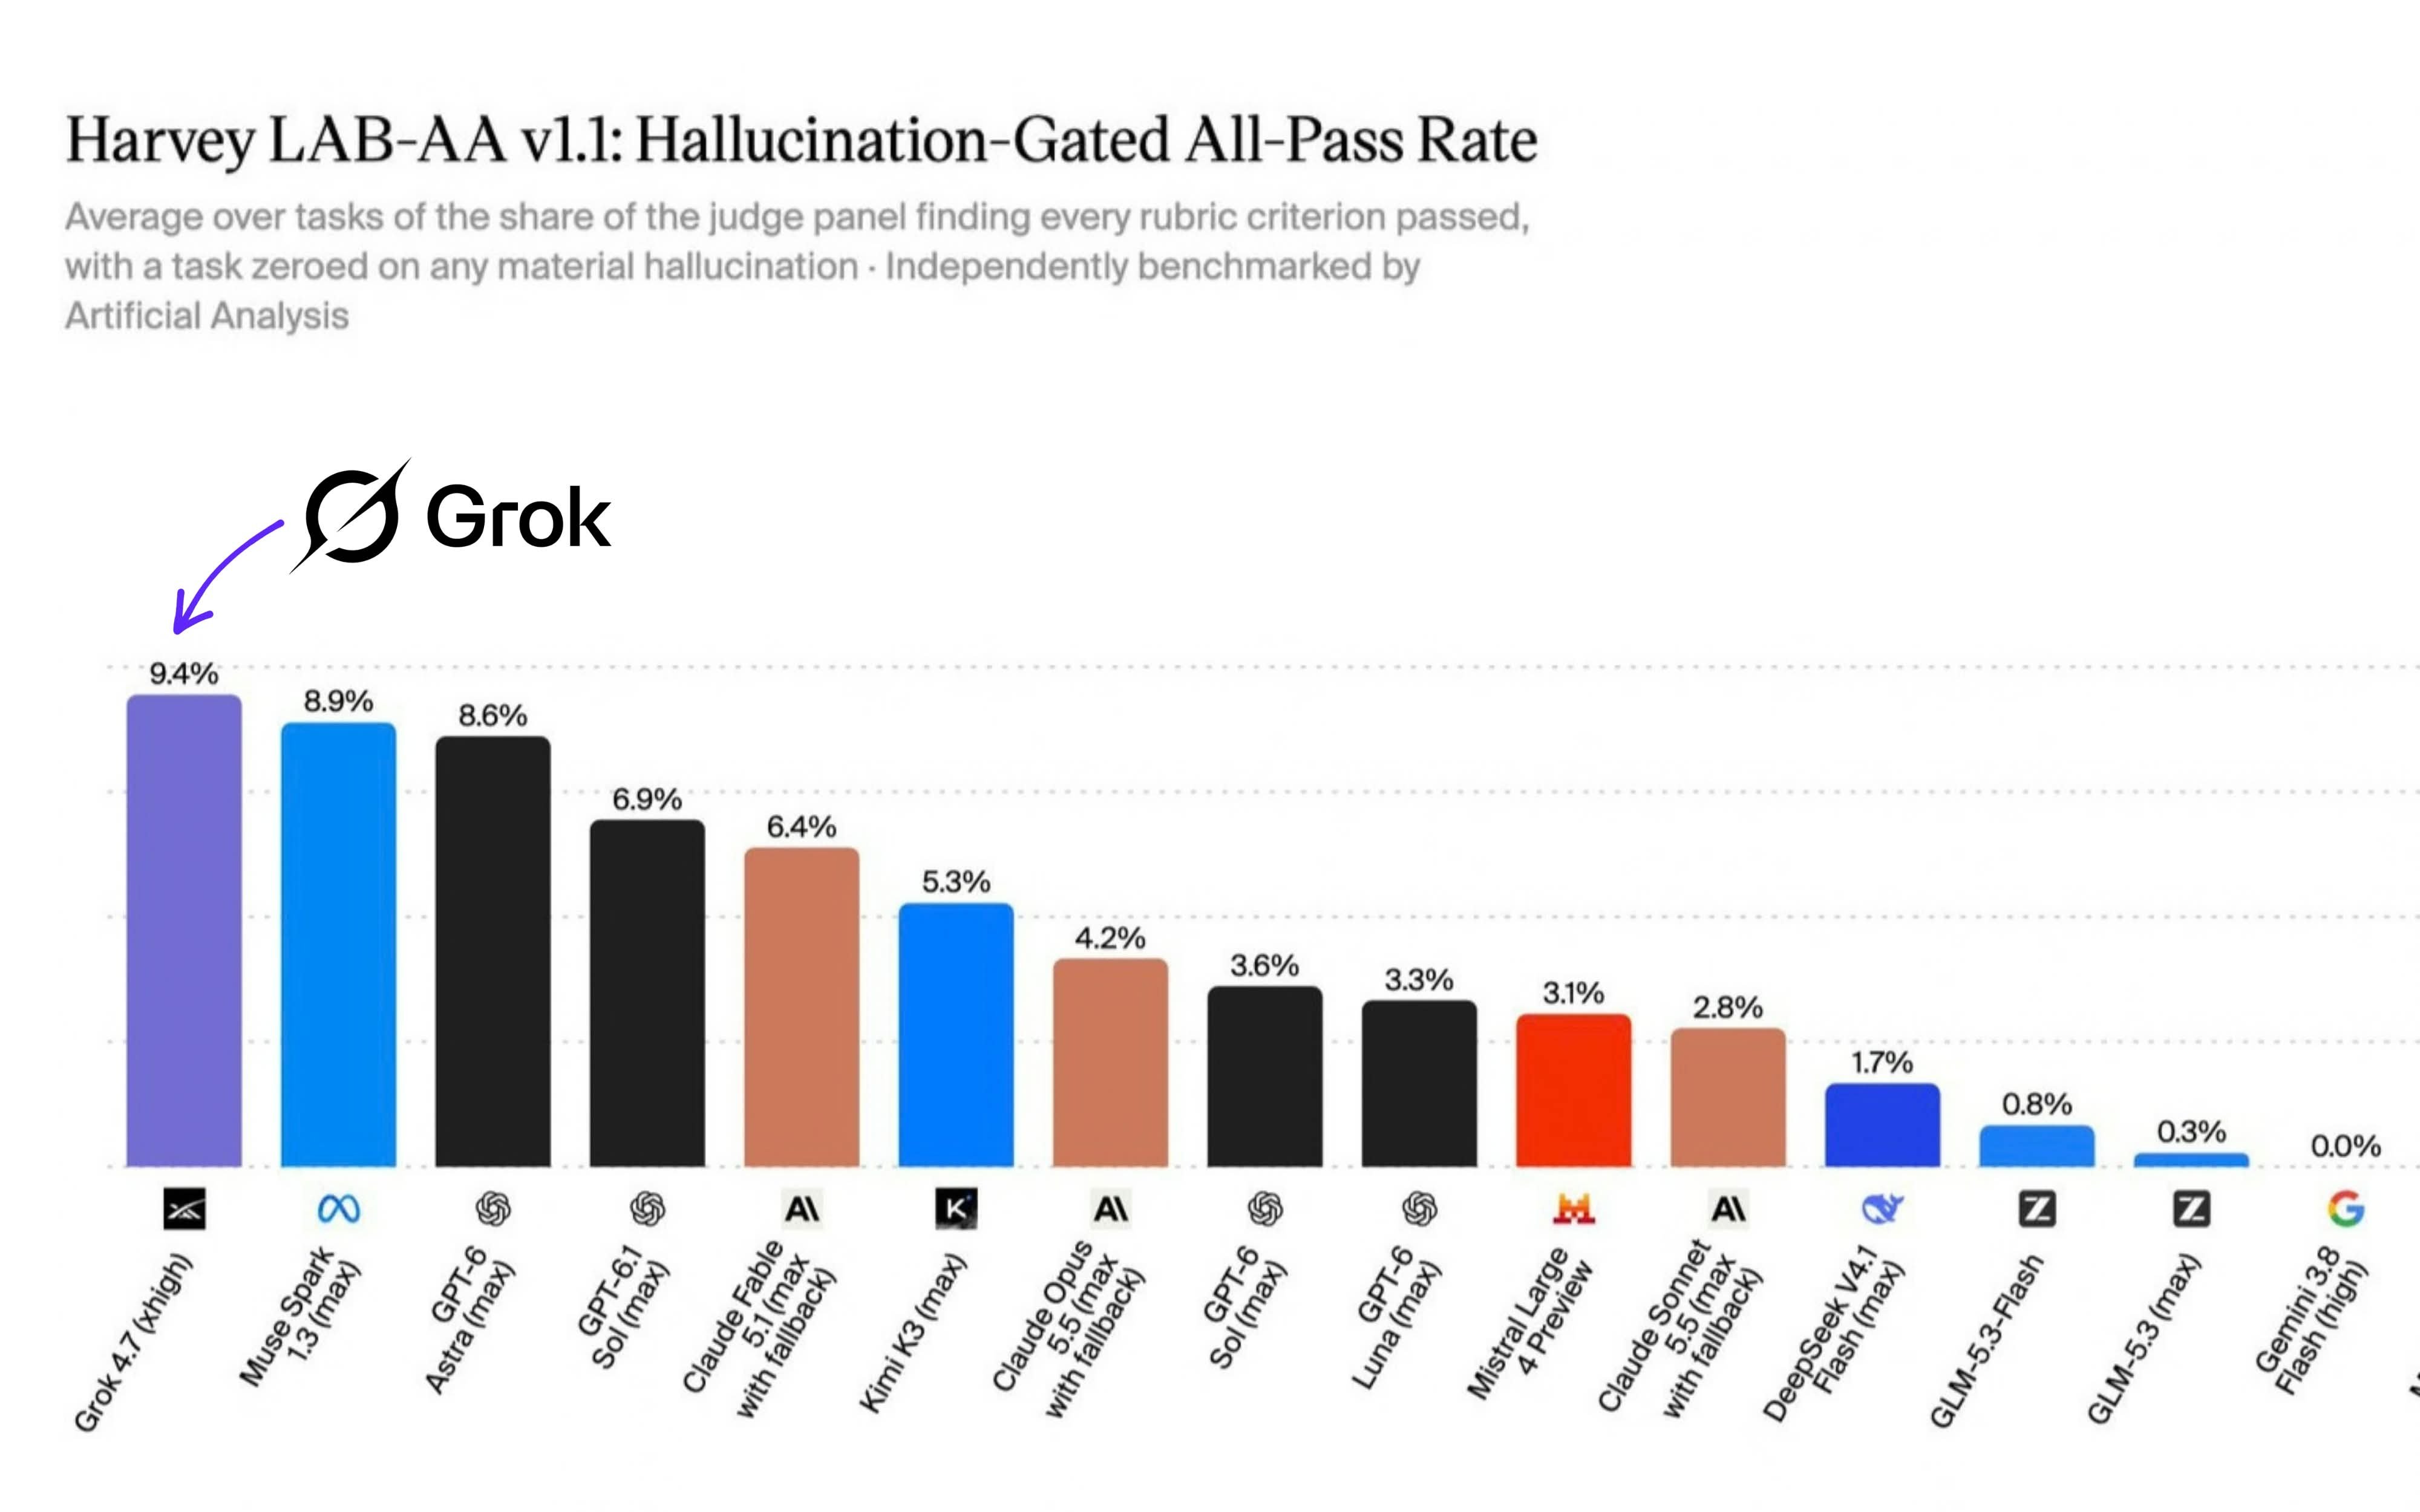
Grok 4.7 登顶 Harvey LAB-AA v1.1 基准测试,以零幻觉表现力压 GPT-6 Astra、Claude Opus 5.5 等顶尖模型
SmartHey10月10日消息:Grok 4.7 在严苛的 Harvey LAB-AA v1.1 基准测试中荣登榜首,力压 Claude Opus 5.5、GPT-6 Astra 和 Muse Spark 1.3 等当前主流大模型。
该基准测试以高容错门槛著称——任何一次实质性幻觉(即生成与事实严重不符的关键性错误信息),即导致整项任务得分为零。其评估逻辑不仅关注答案是否正确,更强调模型能否全程严谨、连贯、无虚构地完成复杂任务,真正考验推理可靠性与事实一致性。