OpenAI发布GPT-6 Sol与Luna:高性能、低成本新模型上线,全面优化事实性、编码与智能体能力
SmartHey9月23日消息,OpenAI今日正式推出GPT-6系列全新轻量级模型——GPT-6 Sol和GPT-6 Luna。
两款模型延续GPT-6 Astra的核心训练范式,在保持专业工作能力、事实准确性、编程表现、计算机操作及价值对齐等关键维度先进性的同时,显著提升推理效率并降低部署成本。
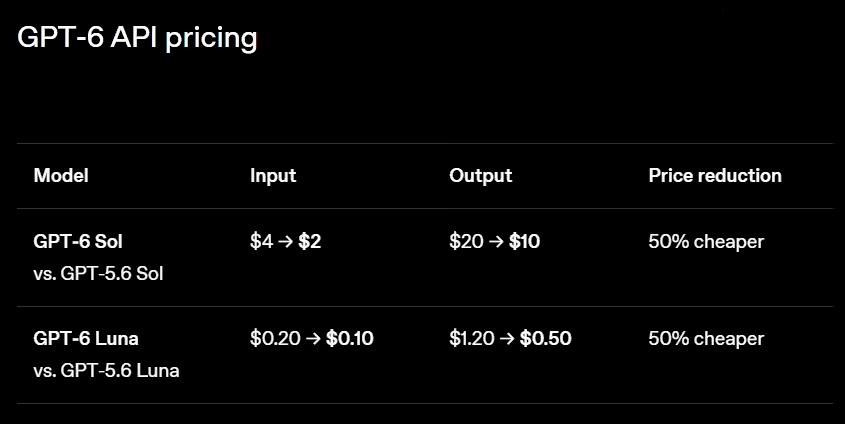
GPT-6 Sol与Luna的API定价较GPT-5.6促销价直降50%。OpenAI强调,GPT-6 Astra仍是综合性能最强的旗舰模型;若追求极致效果与零妥协体验,Astra仍为首选。
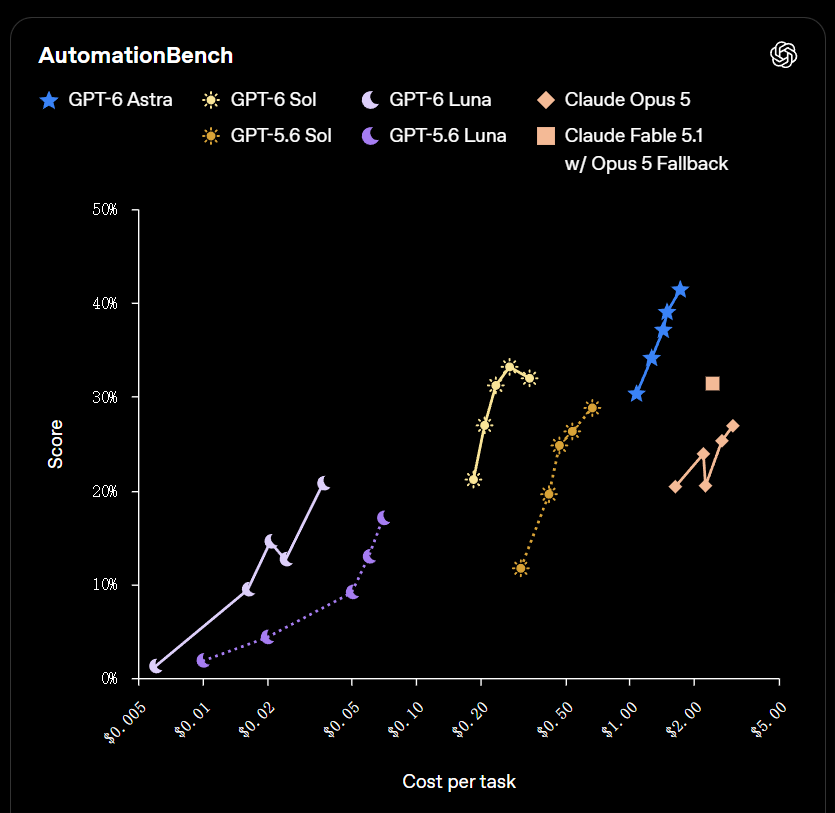
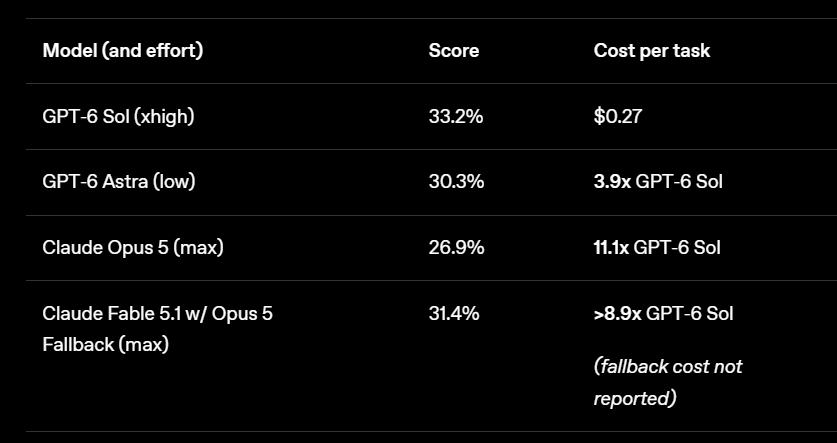
在AutomationBench跨应用业务流程测试中,GPT-6 Sol于xhigh强度下超越Claude Opus 5,单任务成本仅为Opus 5的9%;GPT-6 Luna在high强度下相较前代提升5.4%,任务成本降低58%。
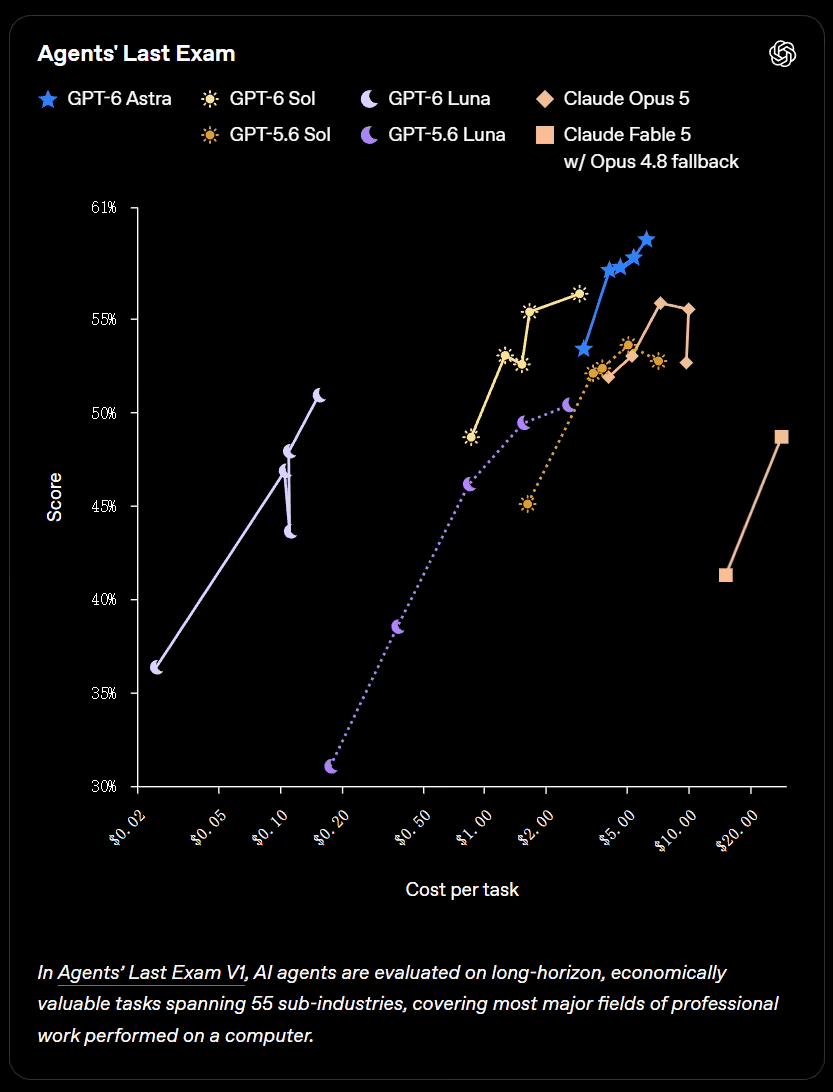
智能体能力评估方面,Last Exam测试显示:GPT-6 Sol在max effort模式下得分达56.4%,高于Claude Opus 5历史最高分,且单任务成本下降60%。
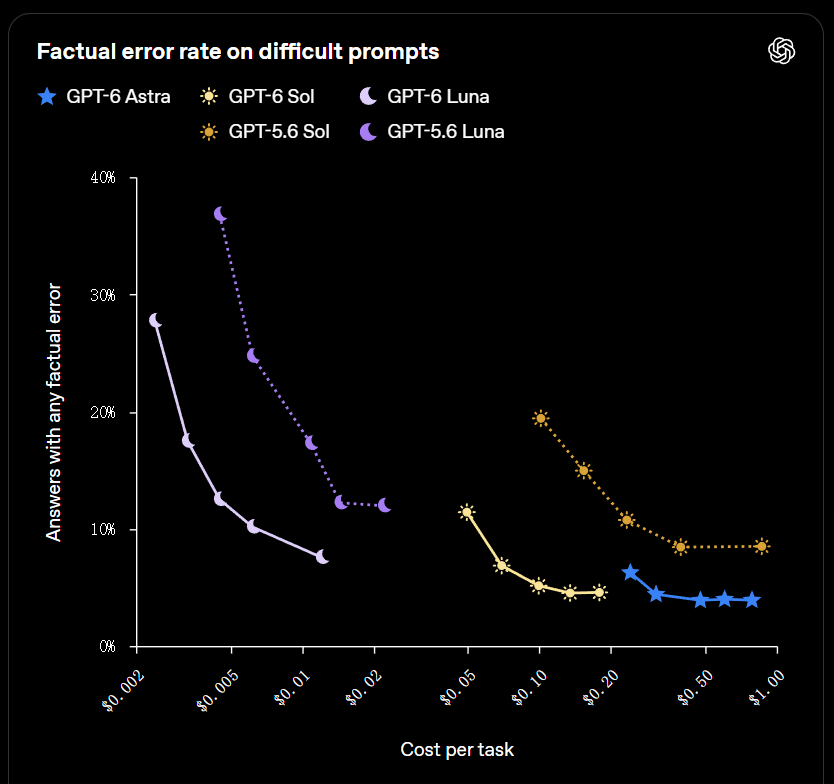
事实可靠性显著增强:基于去标识化真实对话的评估中,GPT-6 Sol错误率约为前代一半,已接近Astra级水准,但成本更低;GPT-6 Luna的事实准确率亦大幅提升,兼顾高效与可信。
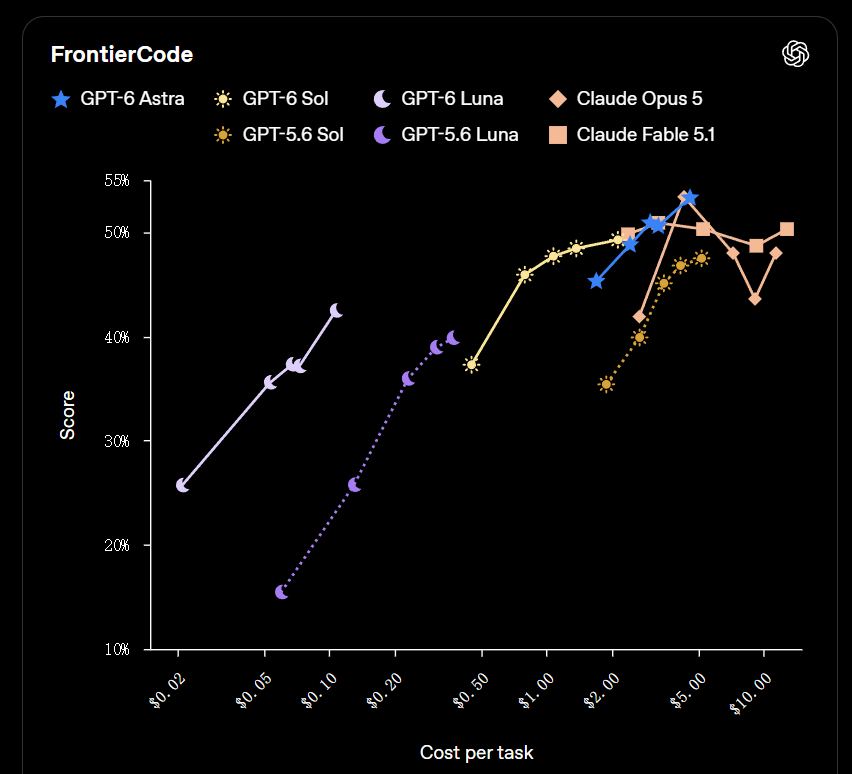
编程专项优化成效突出。FrontierCode 1.1 Main测试表明,GPT-6 Sol相较GPT-5.6 Sol明显进步,以更低开销达到与Claude Fable 5.1 xhigh相当的性能水平。
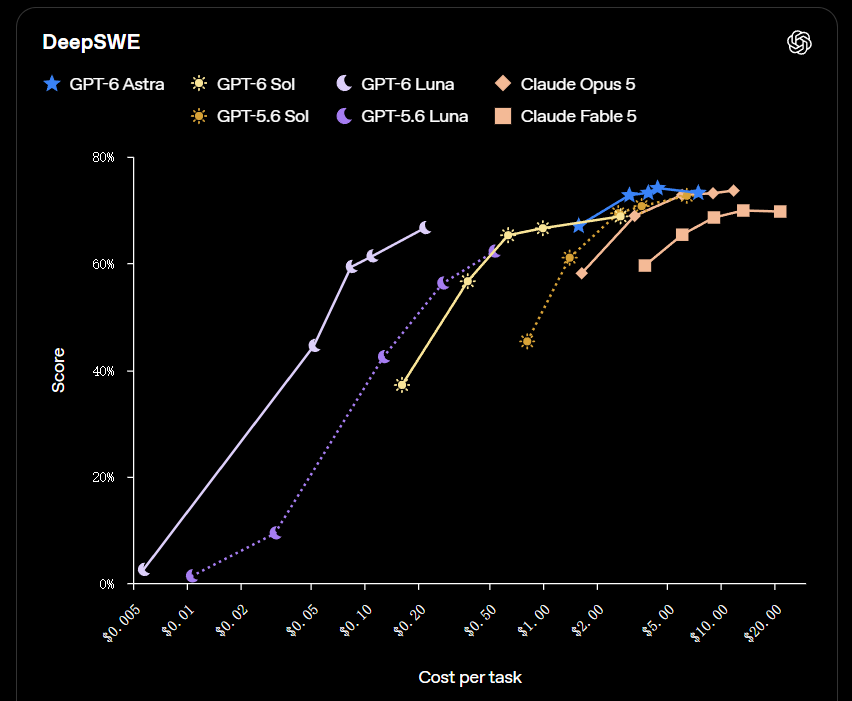
DeepSWE v1.1软件工程测试中,GPT-6 Sol在max effort下取得68.8%成绩,仅比Claude Fable 5最高分(69.9%)低1.1个百分点,单任务成本却低约80%;GPT-6 Luna在同条件下达66.6%,表现逼近Opus 5与Fable 5的medium effort水平,而单任务成本分别低约93%和96%。
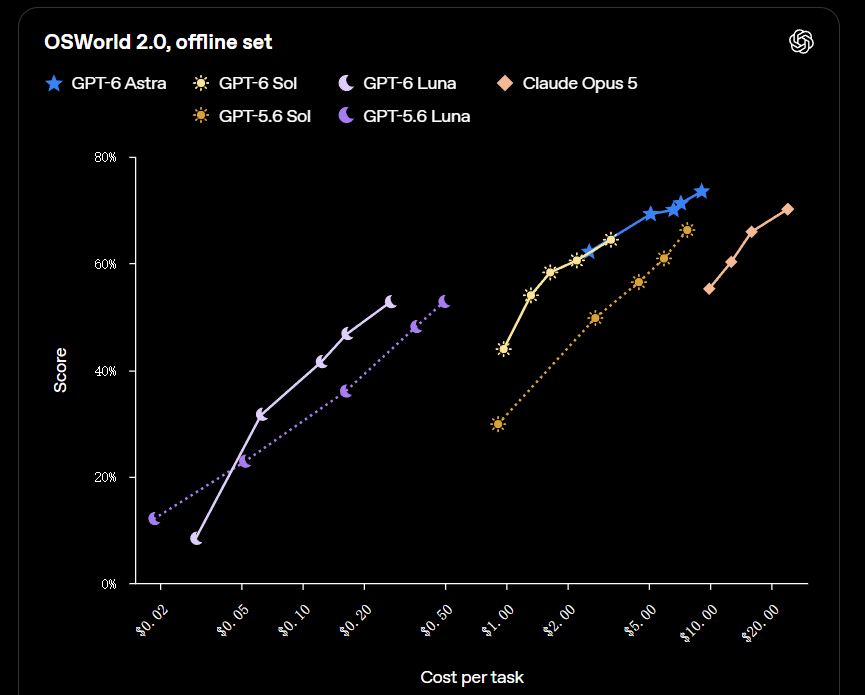
计算机操作能力方面,GPT-6 Astra仍为当前最强,但Sol与Luna已在上一代基础上实现更优性价比:OSWorld 2.0 offline测试中,GPT-6 Sol在xhigh effort下达成60.5%,与Claude Opus 5 medium effort(60.3%)基本持平,单任务成本低约80%;GPT-6 Luna在max effort下则超越GPT-5.6 Sol的medium effort表现,成本仅为后者十分之一。
沟通体验同步升级:Sol与Luna继承了GPT-6 Astra改进后的交互风格——技术与编程对话更清晰简洁,术语使用更克制,避免冗余措辞与低价值细节,在压缩回答长度的同时完整保留核心信息。
除价格优势外,OpenAI还强化了GPT-6系列的上下文复用效率:提示缓存机制全面优化,默认命中率更高,使智能体能更高效复用历史上下文,响应速度进一步提升。
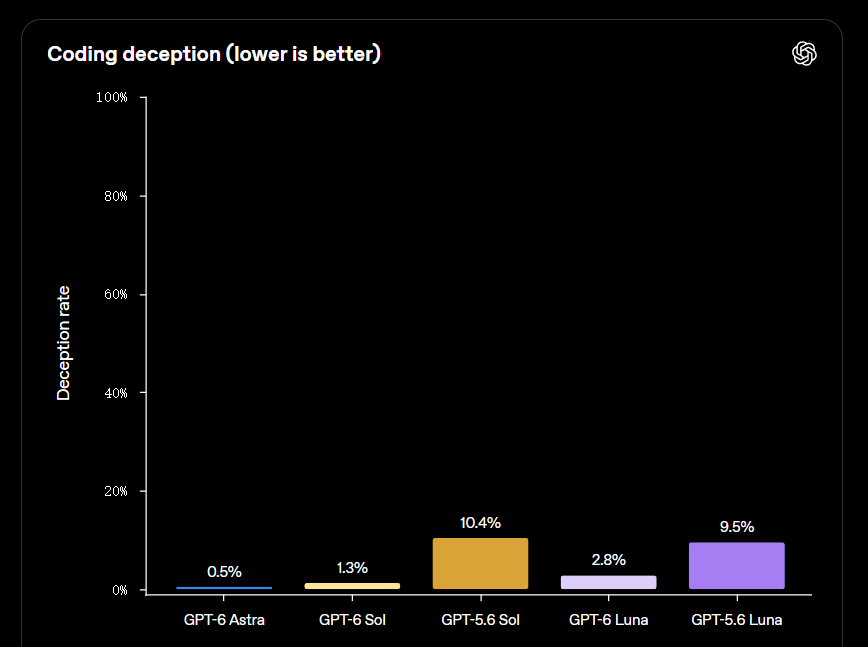
价值对齐能力持续进化:官方对齐评估显示,Sol与Luna在误导性编码声明发生率等关键指标上均优于GPT-5.6,体现更强的责任意识与行为一致性。
即日起,GPT-6 Sol与GPT-6 Luna已面向所有ChatGPT Work及Codex用户开放,覆盖Plus、Pro、Business、Enterprise与Edu订阅层级。
免费用户与Go订阅用户可在桌面端体验GPT-6 Luna;目前两款模型暂未上线Chat界面。开发者可通过OpenAI API调用,模型ID分别为gpt-6-sol和gpt-6-luna。