LlamaIndex发布40亿参数视觉语言模型OCRia-1,专攻复杂文档结构化解析
SmartHey10月23日消息,近日,知名AI开源框架LlamaIndex正式推出全新视觉语言文档解析模型——OCRia‑1。该模型仅含40亿参数,却在ParseBench等多项权威评测中刷新同规模模型纪录,在复杂表格识别、图表数据提取、版式与公式保留等关键任务上表现尤为突出。目前,OCRia‑1已无缝集成至LlamaParse服务,且面向现有用户保持原有定价不变。
随着AI智能体加速落地,企业高频使用的财报、保单、科研论文等文档普遍包含嵌套表格、多类型图表、数学公式及精细排版。传统OCR方案多局限于纯文本识别,极易丢失语义结构与空间关系,难以支撑下游智能体执行计算、比对与逻辑推理;而通用多模态大模型又常在精度、响应延迟与推理成本之间难以平衡。OCRia‑1的核心定位,正是为智能体工作流补齐复杂文档端到端结构化提取这一关键能力短板。
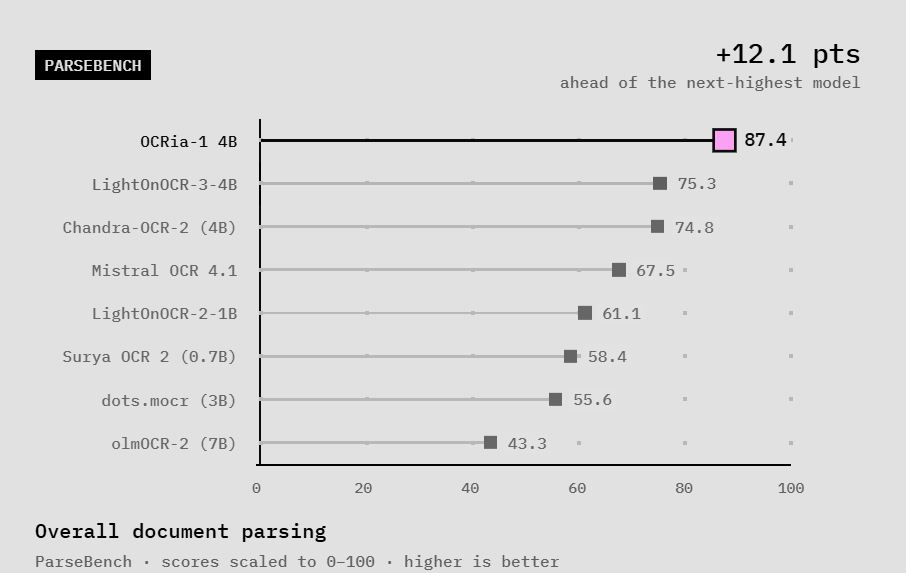
评测结果显示,OCRia‑1在ParseBench综合得分达87.4,在350亿参数以下模型梯队中位列第一,领先第二名12.1分;同时包揽olmOCR‑bench、PulseBench‑Tab、fr‑bench‑pdf2md三项第三方表格专项基准测试冠军。
其核心优势集中于两大高难度场景:一是精准解析含合并单元格、多层表头与不规则网格的财务报表,严格保障字段标签与对应数值的逻辑一致性;二是高效识别折线图、柱状图及多轴复合图表,自动还原坐标刻度、数据系列,并输出可直接用于分析的结构化表格。在ParseBench图表专项测试中,OCRia‑1得分高达85.1,领先第二名19分,而部分竞品模型在该项得分趋近于零。
此外,OCRia‑1支持完整保留上标、下标、复选框等原生格式元素;数学公式可直接输出标准LaTeX代码,避免退化为不可解析的普通文本;在格式保真度单项评测中,亦显著超越同类模型。
上述性能突破源于一套深度适配文档长尾场景的定制化训练范式。LlamaIndex构建了超10万页高质量文档训练集,重点覆盖跨页高密度表格、多样化图表、多语言混排、复杂公式及低质量扫描件等易出错样本。训练流程融合监督微调(SFT)与可验证奖励强化学习(RLVR),依托可校验的结构化输出信号,定向增强模型对表格与图表的空间理解与还原能力,并辅以合成文档数据提升样本多样性与泛化性。
官方确认,OCRia‑1已全面上线LlamaParse平台,所有现有用户无需额外付费即可立即启用更强大的复杂文档解析能力。对金融、保险、科研等强文档依赖行业的开发者而言,这意味着在构建文档智能系统、RAG应用或垂直领域业务智能体时,能够以更小模型开销,稳定处理以往高度依赖人工的复杂报表与附图,切实降低企业文档数字化与AI赋能的落地门槛。