华为发布Agentic计算新范式:超节点+集群架构加速AI原生时代落地
撰文 | 李信马
题图 | SmartHey摄
“今天中国日均Token消耗量约500万亿。按单卡每秒2000 Token吞吐能力、一天86400秒计算,支撑100万亿Token需约57.87万张AI加速卡;考虑负载波动,实际需乘以1.3冗余系数,即约75.23万卡——这构成了当前智算基础设施的基本规模。此外,还需配套约7万台通用计算服务器,用于沙箱管理、任务调度、MCP Server等通算服务,共同支撑Agentic时代的海量并发需求。”
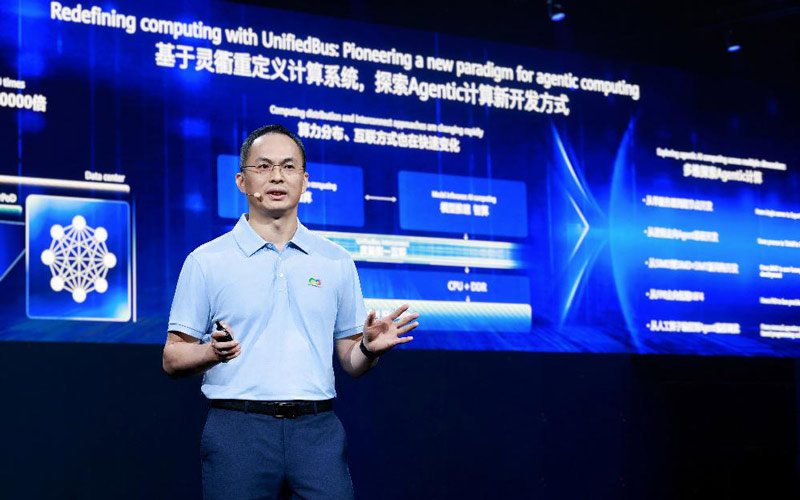
9月19日,在华为全联接大会2026期间,华为计算首席战略官朱照生在主题演讲中首次系统披露了这一关键算力推演。随着Agent深度融入企业决策与个人工作流,一次长程任务可能耗时数分钟甚至数小时;每一次思考、评估与回滚,都在指数级放大算力开销。当“等待时间”从毫秒累积为分钟,效率的分水岭已然显现。
Token正成为新型生产要素,而算力的分布密度、互联效率与调度粒度,已成为决定智能化进程快慢的核心变量。正如朱照生所言:“Token的输出,应该像闪电一样!”实现这一目标的关键,在于突破时延瓶颈。面对迈向十万亿参数的大模型,单机已无法承载训练与推理负载,“超节点集群”正从技术构想走向产业现实。在2026世界人工智能大会(WAIC)发布的《超节点定义与实践白皮书》中,超节点被明确定义为:物理上由多个计算节点通过高速互联协议紧密耦合,具备跨节点统一内存编址能力,逻辑上呈现“一台计算机”特征的新型计算系统。朱照生指出,未来通算与智算将共置同一机房,通算本身也需升级为超节点架构,以支撑多Agent协同所需的海量轻量化沙箱,并实现秒级弹性启动。
伴随这一底层变革,Agentic时代的开发范式与计算生态,正在同步重构。
01、算力新底座:从集群到超节点的范式跃迁
回溯算力演进史可见:从单机多卡、多机集群,到如今的“超节点+集群”,驱动变革的始终是需求侧的真实压力——模型参数量与训练集群规模持续膨胀,传统架构的物理局限日益凸显。典型瓶颈在于通算与智算长期分处不同机楼,相距数百米乃至数公里;光信号传输1公里往返时延已达10微秒,而在高频Agent交互中,网络交换层的毫秒级延迟正被反复叠加,最终酿成分钟级响应鸿沟。
为此,华为提出面向Agentic时代的五大开发升级方向:覆盖从单服务器到超节点的开发体系、从传统“进程”到“思程(ThinkProcess)”的运行单元演进、从SIMD到SIMD+SIMT混合编程、从HiF8向低精HiF4的数据格式跃迁、以及从人工算子调优到Agent化自动编程调优。
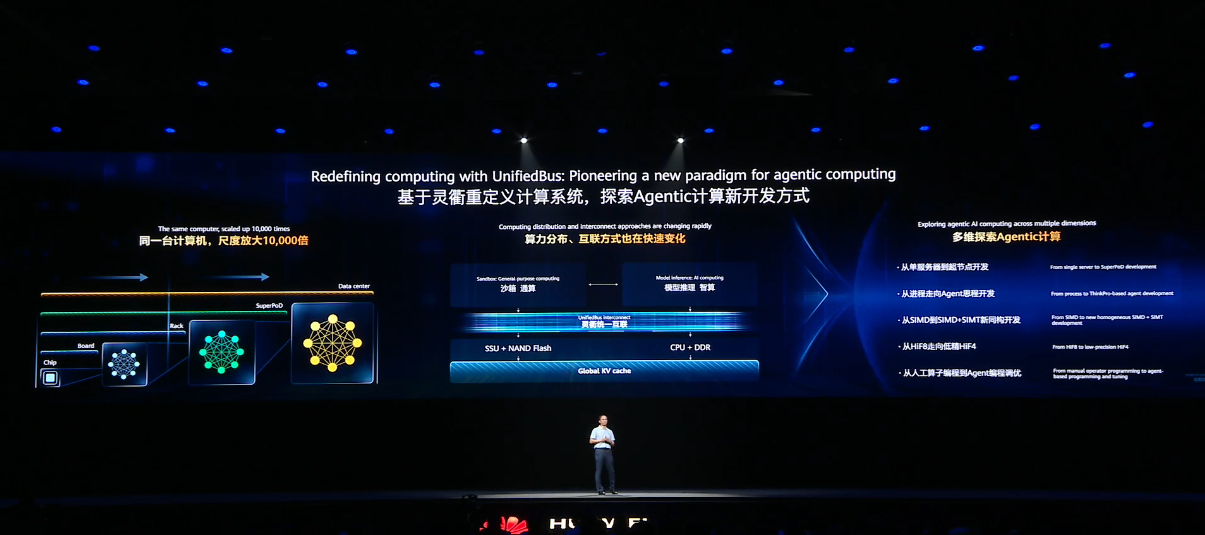
针对超节点开发,华为提供原子化、细粒度的接口支持。例如,在离散高频的小数据通信场景下,超节点内存语义接口(跨物理节点load/store同步访问)可显著降低通信开销。“以一个256专家并行系统为例:若每颗芯片运行一个Expert,支持96用户并发,则模型每层All-to-All通信频次超700万次,其中90%以上为仅几个字节的小包。”朱照生解释道。
而对大块连续数据传输,超节点消息语义接口(URMA异步访问)则可高效支撑。该能力不仅让海量Agent沙箱实现秒级冷启,更可赋能KV Cache多级存储、搜索推荐等典型场景,依托鲲鹏通算超节点提升整体性能与资源收益。
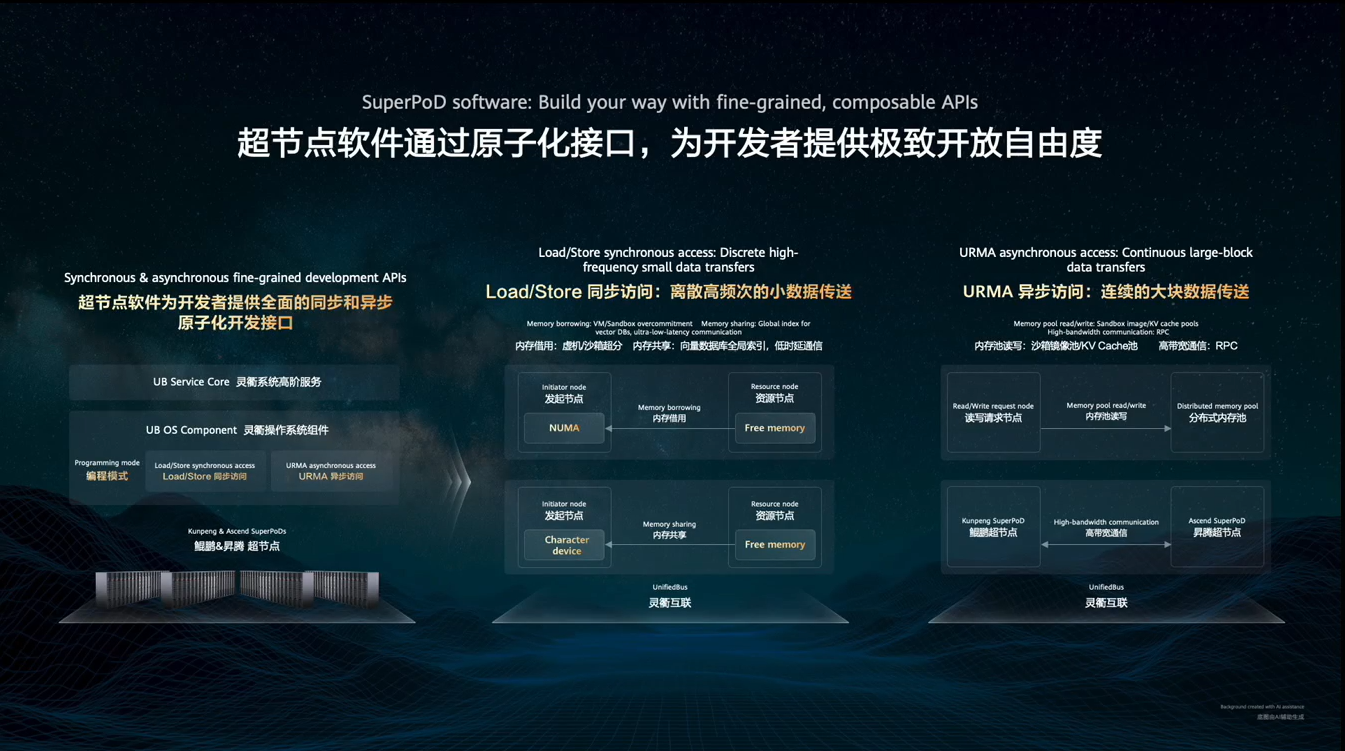
操作系统层面亦迎来根本性变革。过去以“进程”管理预设逻辑程序,而Agent需持续开放探索最优解。openEuler由此推出“思程(ThinkProcess,ThinkPro)”——作为Agent思考、执行、探索与演进的基本单元。其提供原子级API体系:User Space API负责状态全生命周期管理(创建/退出/融合/回滚);Kernel Space API实现CPU、内存等硬件资源抽象,支持通算与智算的融合调度与异构池化。
在昇腾950新代际上,Ascend C全面升级编程模型:新增SIMD与SIMT混合模式,开发者可在同一算子内核中自由组合——如“gather and add”算子,先以SIMT完成离散访存,再用SIMD执行连续累加;引入RegBase编程模式,将数据搬运与寄存器计算交由开发者自主控制;虚拟指令集PTO-ISA已涵盖基本运算、数据搬运、通信等8大类、120余条指令,通过Tile级抽象保障代际兼容与源码跨代迁移,并支持Auto/Manual双模式实现底层硬件的细粒度操控。“Ascend C的全新升级,本质是为开发者打造更高性能、更自由的编程环境。”朱照生表示。
在数据精度方面,低比特计算已成为AI基础设施的必然选择。华为去年发布的8位浮点格式HiFloat8进展远超预期:团体标准已定稿,8月正式完成国标立项(TC28),并启动IEEE研究组申请;HiFloat社区汇聚超100家单位,包括清华、中科院、高通、科大讯飞等产学研头部力量。目前,HiFloat8已在芯片、算子、训推框架至模型应用全栈完成验证——训推精度与BF16平均误差控制在0.5%以内,性能提升约30%。面向4bit,HiFloat4创新采用E6M2全局缩放因子与2级局部微阶码,在极低比特下实现更高精度元素表达。预计未来数月,首批基于HiFloat8优化的大模型将陆续商用落地。
最后,在工具链层面,华为构建了覆盖“算子生成→模型适配→精度调优→行业部署”全周期的Agent化能力:CANNBot支持Vector类算子3小时内自动生成(传统人工开发需数天);Model Agent自动编排适配流程与优化策略,免除繁琐迁移;MindStudio Agent实现从集群到芯片的多级精度调优,压缩至小时级;Solution Agent内置300+行业参考方案,几分钟内即可完成参数寻优,打通AI落地“最后一公里”。
02、生态商业化:开源开放驱动规模化落地
技术先进性之外,Agentic计算能否真正落地,更取决于生态的广度、厚度与开放性。
过去七年,鲲鹏生态已完成从起步到规模化的跃迁:openEuler自2019年12月发布,2021年捐赠至开放原子开源基金会,累计部署超2000万套,稳居中国服务器操作系统市占率第一;鲲鹏汇聚416万开发者、7200家ISV伙伴,联合打造2.8万个解决方案,广泛应用于金融核心银行系统、手机银行、运营商CRM与计费平台、互联网搜索推荐广告等关键业务场景。实测显示,鲲鹏冷热数据识别准确率达99%,KAE压缩开销低于5%(业界平均约20%),沙箱内存超分率达30%——某股份制银行在同等性能下,单台服务器内存需求从512GB降至384GB。
更令人瞩目的是昇腾生态的爆发式增长。朱照生在现场宣告:“昇腾已跨越生态拐点!”
依据最新数据:自今年6月起,CANN社区跃升为中国最活跃开源社区,月活用户超5200人,非华为开发者数量首次超越华为内部开发者;日均新增合入代码超3万行;基于CANN原生训练的大模型与多模态模型已超40个。尤为关键的是,7月28日昇腾正式成为PyTorch官方支持的首个中国算力平台,全球PyTorch开发者可直接在昇腾硬件上开展创新开发。
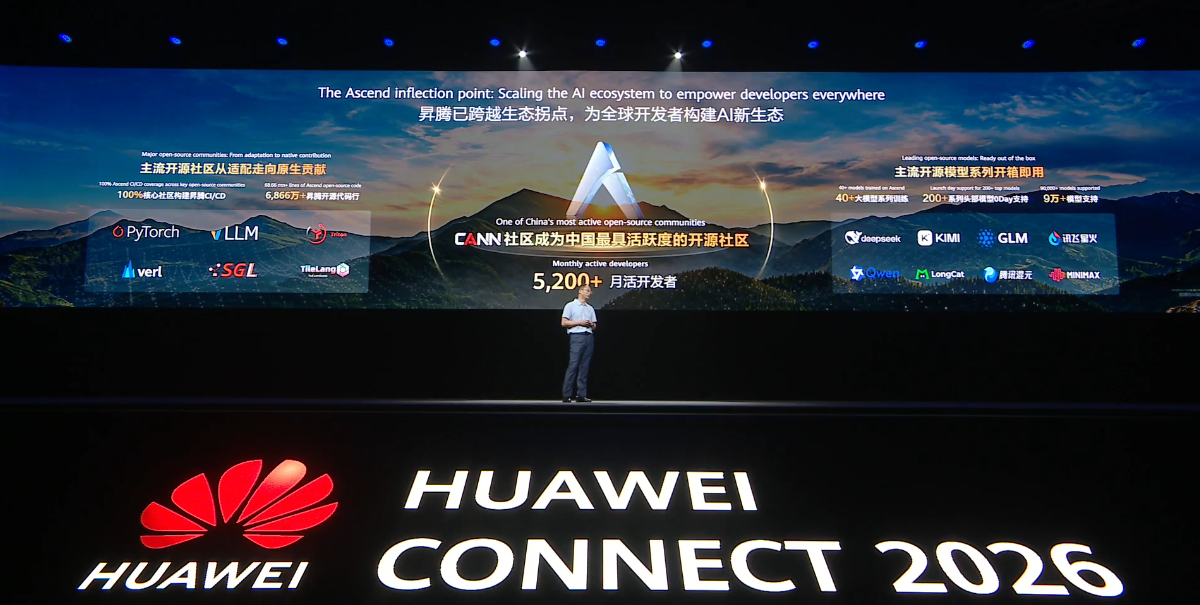
让开发者真正成为生态共建者,是华为下一阶段的核心策略。昇腾开源社区已上线万卡级算力集群,注册即赠100卡时;提交Issue、PR可获积分,积分可兑换更多卡时资源。对个人开发者与中小企业而言,万卡集群不再是巨头专属,而是“按贡献即享”的普惠基础设施。社区CI/CD流程全面Agent化:等待时间从数十分钟压缩至分钟级;Issue自动回复与PR自动审核质量已达人类专家水平,形成“写代码→测试→合入”的端到端闭环。
资金投入层面,华为明确承诺:过去三年已投入30亿元,未来三年将追加投入50亿元,专项建设开源开放的算力新生态,聚焦三大方向:
- 能力筑基:依托鲲鹏昇腾社区与开发者学习中心,提供场景化成长路径与知识体系,夯实开发者技术根基;
- 持续创新:通过鲲鹏昇腾生态创新中心、卓越孵化中心等载体,联合高校与企业开展联创项目,推动开发者在实战中持续进阶;
- 产研协同:实施“鲲鹏昇腾种子计划”与“伙伴计划”,从资源、技术、市场多维度赋能,共创商业价值。
华为正将新一代算力基础设施的演进节奏,与开发者生态的开放程度深度绑定。
结语
Agentic时代的到来,标志着算力竞争已从单点性能比拼,升维至基础设施互联密度、开发范式开放效率与生态活力厚度的系统性较量。华为以开源开放为路径,以“超节点+集群”为技术底座,把选择权、定义权与创造权真正交还给开发者。Agentic时代的答案,不会诞生于一家企业的封闭实验室,而将在千万开发者的协作中自然涌现。我们期待,那一天的算力,真的能“像闪电一样”——随叫随到、毫秒响应、无限可扩展。
关于华为计算的故事,仍在加速书写。