字节Seed团队揭示DeepSeek长上下文推理“抽风”根源:分块KV缓存压缩引发相位敏感性
SmartHey10月9日消息,字节跳动Seed团队于今年9月底在预印本平台arXiv发布一项重要研究,首次系统揭示了分块KV缓存压缩技术所引入的“相位敏感性”问题,并指出该机制可能是DeepSeek系列模型在长上下文推理中出现性能波动(俗称“抽风”)的关键成因。
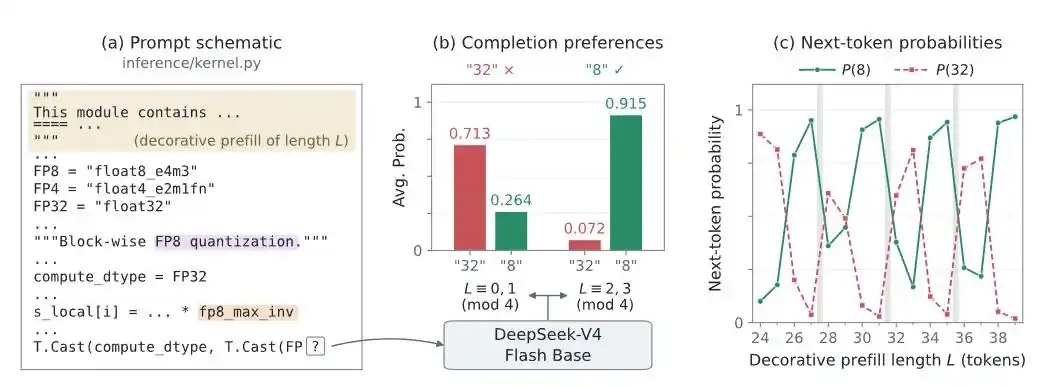
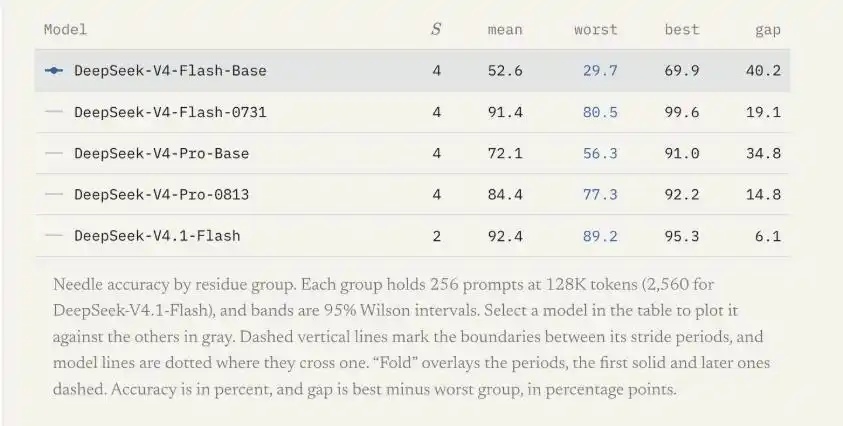
研究覆盖多个主流变体:基础版与后训练版的DeepSeek-V4-Flash、DeepSeek-V4-Pro,以及升级后的DeepSeek-V4.1-Flash,全面评估其在不同压缩策略下的行为一致性。
分块KV缓存压缩通过固定步幅将连续token划入窗口并聚合为更少的缓存条目,显著降低长上下文推理所需的内存占用与注意力计算开销——这一优化被广泛用于提升大模型推理效率。
但该研究指出,压缩过程隐式引入了一个新的结构化坐标:Token的“相位”(phase),即其在压缩窗口内的相对位置(如窗口起始偏移量)。这一维度未被现有模型架构显式建模,却深刻影响信息检索稳定性。
团队实证发现,采用此类压缩的模型普遍存在系统性不对称现象:相同语义信息在特定相位下可被高效检索,而在另一相位下召回率骤降。他们将这种周期性性能起伏定义为“相位敏感性”(phase sensitivity)。
在多个开源大模型中,长上下文问答与检索任务的准确率随相位变化呈现明显波动,峰值与谷值差距最高达40个百分点——这意味着仅依赖平均基准分数可能严重掩盖模型在真实长文本场景中的结构性短板。