Meta等机构发布SWE-sweep新基准:推动AI从“被动修Bug”迈向“主动巡检”
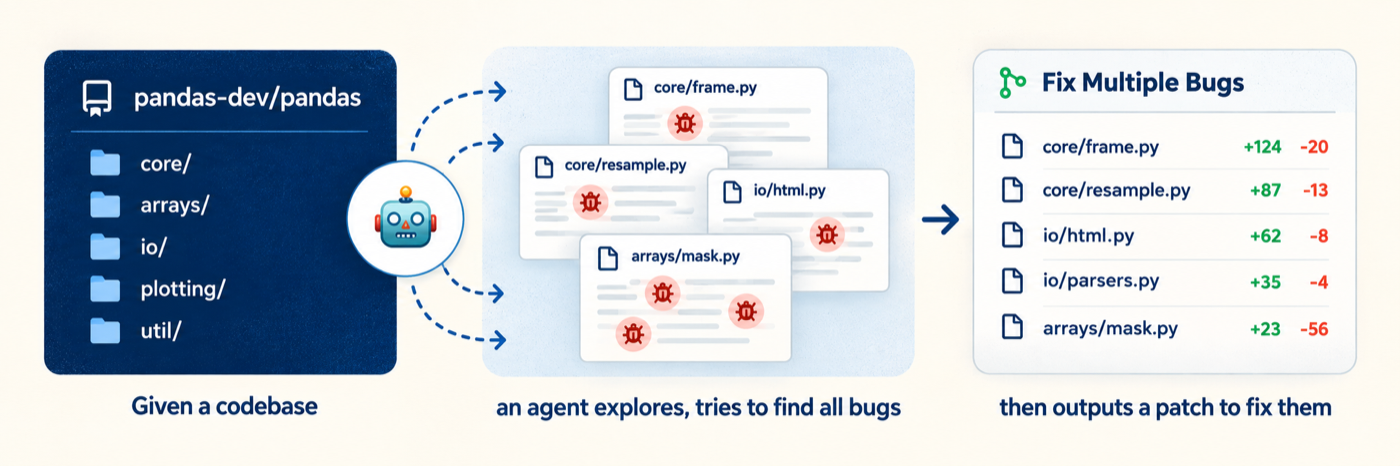
(文/杨亮)SmartHey10月23日消息,近日,来自Meta超级智能实验室、哈佛大学、斯坦福大学等机构的研究者联合推出全新软件工程评测基准SWE-sweep,彻底革新当前主流代码评测范式:不再向AI提供问题描述、报错日志或漏洞定位线索,仅交付完整代码仓库,要求编码智能体自主探索、识别并修复潜藏缺陷。
相较SWE-bench等传统基准——其任务形式多为“给定Issue描述+代码库,AI依反馈修复漏洞”,相当于明确告知AI“问题在哪、是什么”,SWE-sweep聚焦更贴近真实生产环境的挑战:在用户尚未上报前,由AI主动对上线代码开展静默巡检,挖掘未暴露的隐性缺陷。
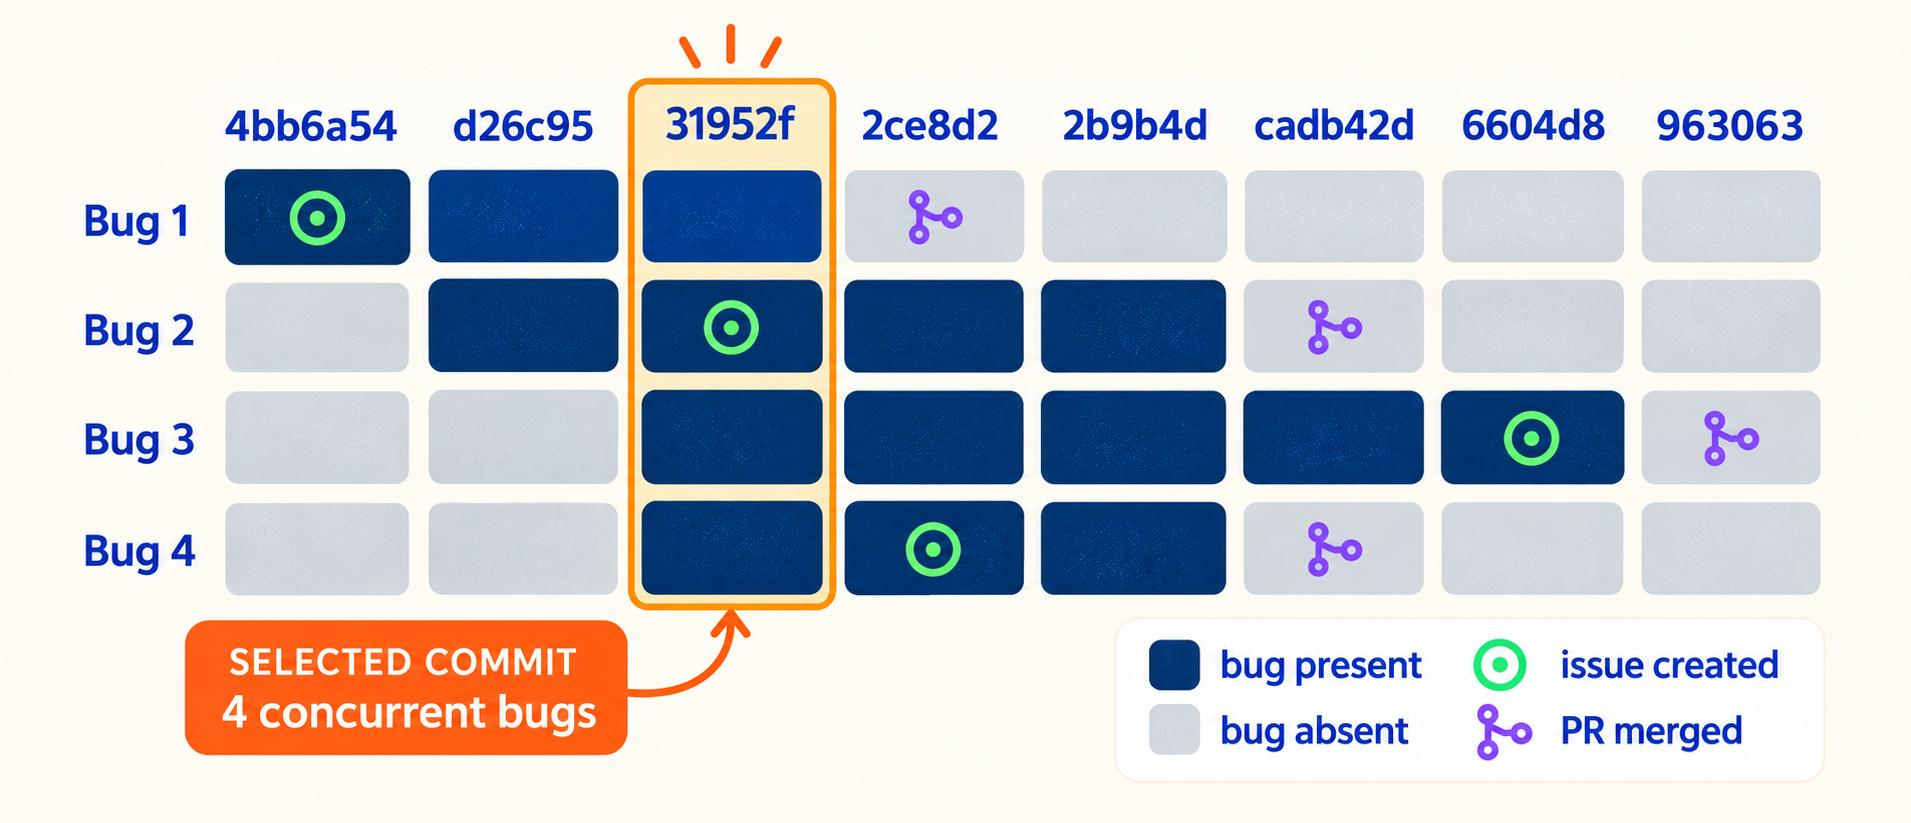
该基准数据集基于100个真实开源项目构建,涵盖4100个历史已修复漏洞。研究团队精心筛选特定提交版本,使多个历史Bug在同一快照中共存;同时严格过滤样本,仅保留“仅通过代码库内部信息即可推断”的缺陷——例如可通过注释说明、类型提示、单元测试断言或函数契约等显式线索识别的问题,排除依赖外部文档、运行时日志或用户行为数据等不可控上下文的案例。
评测机制极为严苛:一个漏洞视为成功修复,须同时满足两项硬性条件——其专属隐藏测试用例由失败转为通过,且仓库原有全部测试套件100%通过,杜绝“修复旧Bug引入新回归”的情况。AI额外发现并修复榜单外未知问题不加分;任何改动若导致既有功能失效,本次评测即判零分。
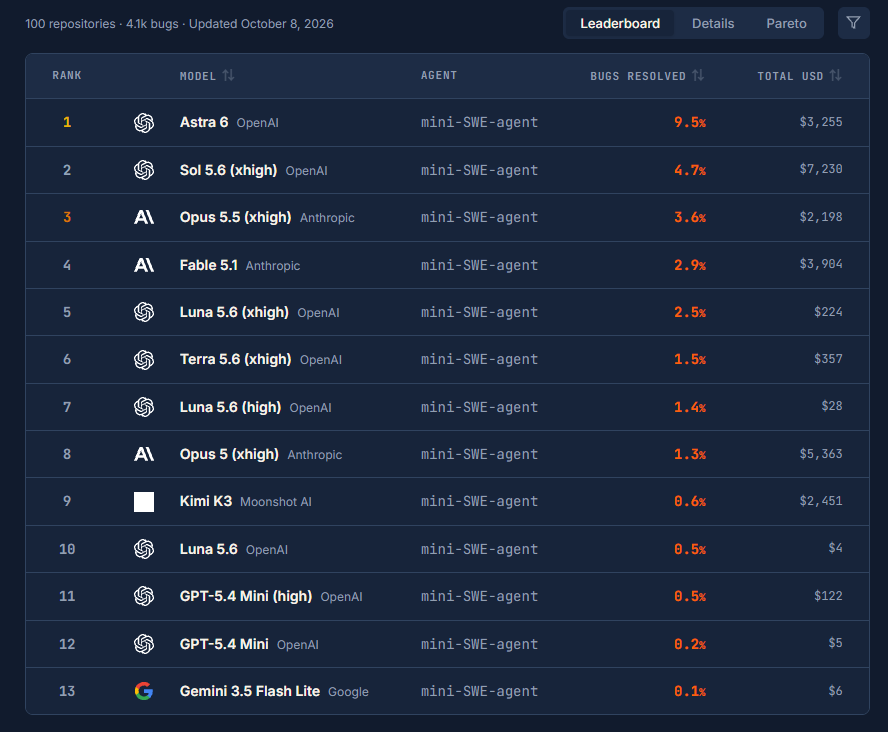
官方同步发布首期排行榜,所有模型统一运行于mini‑SWE‑agent智能体框架。数据显示,当前AI自主修复能力仍处早期阶段:榜首OpenAI Astra 6修复率仅为9.5%,单仓库平均成本32.5美元;第二名OpenAI Sol 5.6(xhigh)修复率4.7%,但成本升至72.3美元;第三名Luna 5.6(xhigh)修复率2.5%,成本显著降低。国内模型月之暗面Kimi K3位列第9,修复率0.6%;其余主流大模型普遍低于1%。
结果亦揭示效率与成本的深层权衡:更高算力与推理配置虽可提升修复数量,但边际收益快速衰减;多轮迭代修改反而增加风险——后续代码变更可能破坏此前已修复的缺陷,并非迭代次数越多效果越好。消融实验进一步证实,在该基准下,Claude Code、Codex等其他智能体框架相较mini‑SWE‑agent并无显著优势。
目前评测通道暂未开放,团队表示后续将持续扩容榜单,计划纳入Astra、Fable及更多开源模型的评测结果。
研究者强调,SWE-sweep的核心目标是推动编码智能体从“工单驱动型修复者”转向“系统级主动守卫者”,这一步,正是通向长期自治软件工程智能体的关键跃迁。