Android Bench最新榜单发布:Claude Sonnet 5.5登顶,Gemini 4 Argon首秀垫底
SmartHey10月28日消息,谷歌近日更新了专用于评估AI模型安卓编程辅助能力的Android Bench基准榜单。在本次更新中,谷歌自家新发布的Gemini 4 Argon表现不及预期,综合排名位列第五,显著落后于Claude Sonnet 5.5、Claude Sonnet 5、GPT-6.1 Sol等主流前沿模型。
Android Bench于2026年初正式推出,旨在为安卓开发者提供一套权威、场景化、可量化的AI辅助开发能力评估标准。该基准不仅覆盖安卓平台特有的开发任务(如Gradle配置优化、Jetpack Compose组件调试、Manifest权限校验等),还严格遵循安卓官方最佳实践,并将平均单次调用成本纳入核心评估维度,助力开发者兼顾性能与成本效益。
在10月26日的最新一轮更新中,谷歌首次为所有参测模型标注了推理等级(Reasoning Tier),并新增了多款重磅模型的实测数据,包括OpenAI的GPT-6 Sol、GPT-6.1 Sol,Anthropic的Claude Sonnet 5与Sonnet 5.5,以及谷歌自研的Gemini 4 Argon。
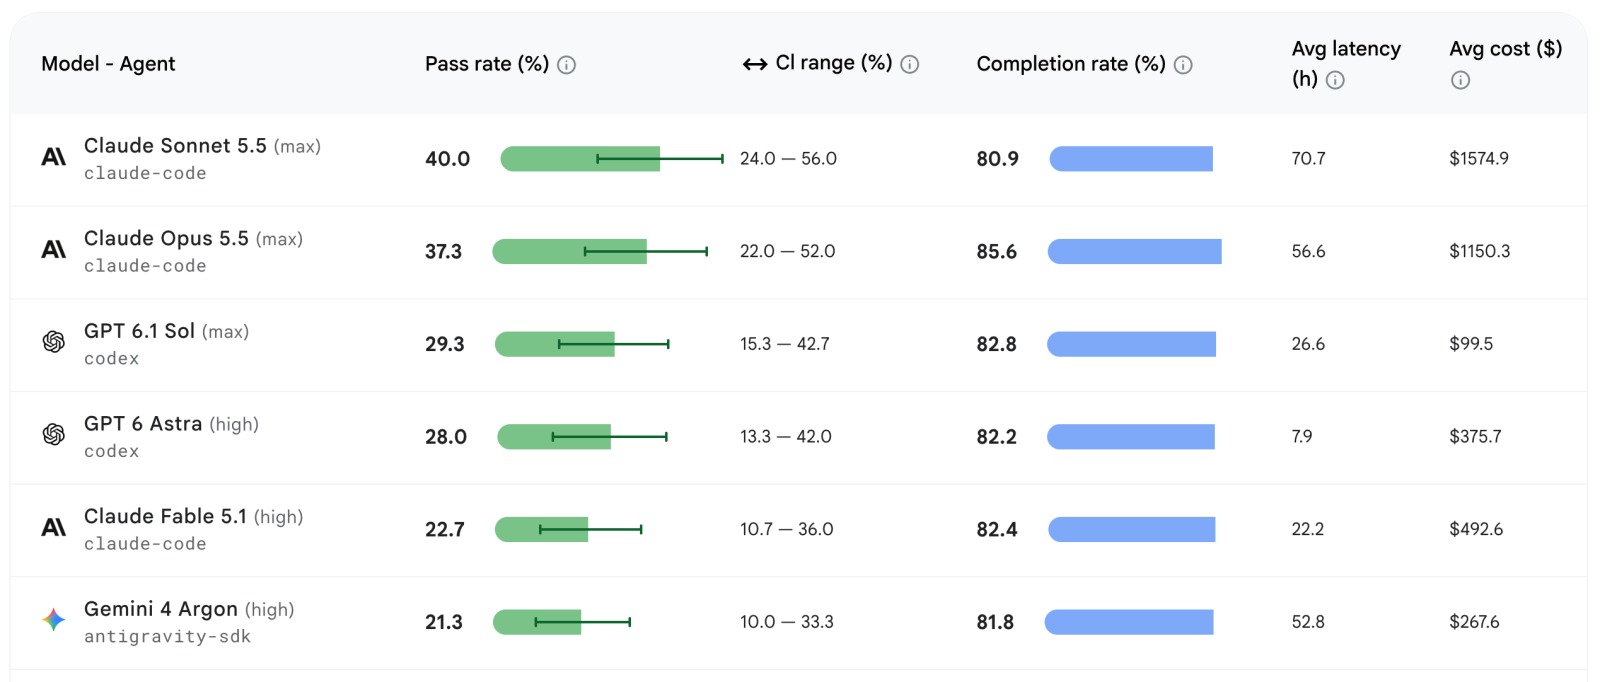
当前榜单榜首由Claude Sonnet 5.5摘得,其任务通过率达40%,完成率达80.9%;紧随其后的是10月初上榜的Claude Opus 5.5,位列第二。
值得关注的是,OpenAI最新推出的GPT-6.1 Sol成为本次更新中的高性价比代表:通过率29.3%,完成率高达82.8%,而平均调用成本仅为99.50美元——不足榜首Claude Sonnet 5.5(1,574.90美元)的十七分之一。
Gemini 4 Argon作为谷歌重点推介的新一代编程专用模型,在本次Android Bench首秀中仅取得21.3%的通过率与81.8%的完成率,调用成本为267.70美元,排名第五,甚至低于此前已上线的Claude Fable 5.1。
据此前内部信源透露,在Gemini 4 Argon官宣前后,已有部分谷歌工程师反馈其在复杂安卓构建流程与多模块依赖解析等任务中存在响应不稳定、逻辑跳步等问题。尽管如此,谷歌仍强调该模型在代码补全、文档理解等基础场景中具备实用价值,并表示将持续迭代优化。