MMGR评测发布:揭示多模态生成模型视觉质量与推理能力间的显著鸿沟
SmartHey10月26日消息,当前先进的多模态生成模型虽能产出高保真、高流畅度的图像与视频,但其是否真正具备物理、逻辑、空间与时序等维度的深层推理能力,仍属未知。当用户下达‘生成解决方案’类指令时,模型究竟是严格遵循任务约束进行因果推演,还是仅依赖统计模式生成表面合理却内在失洽的媒体内容?
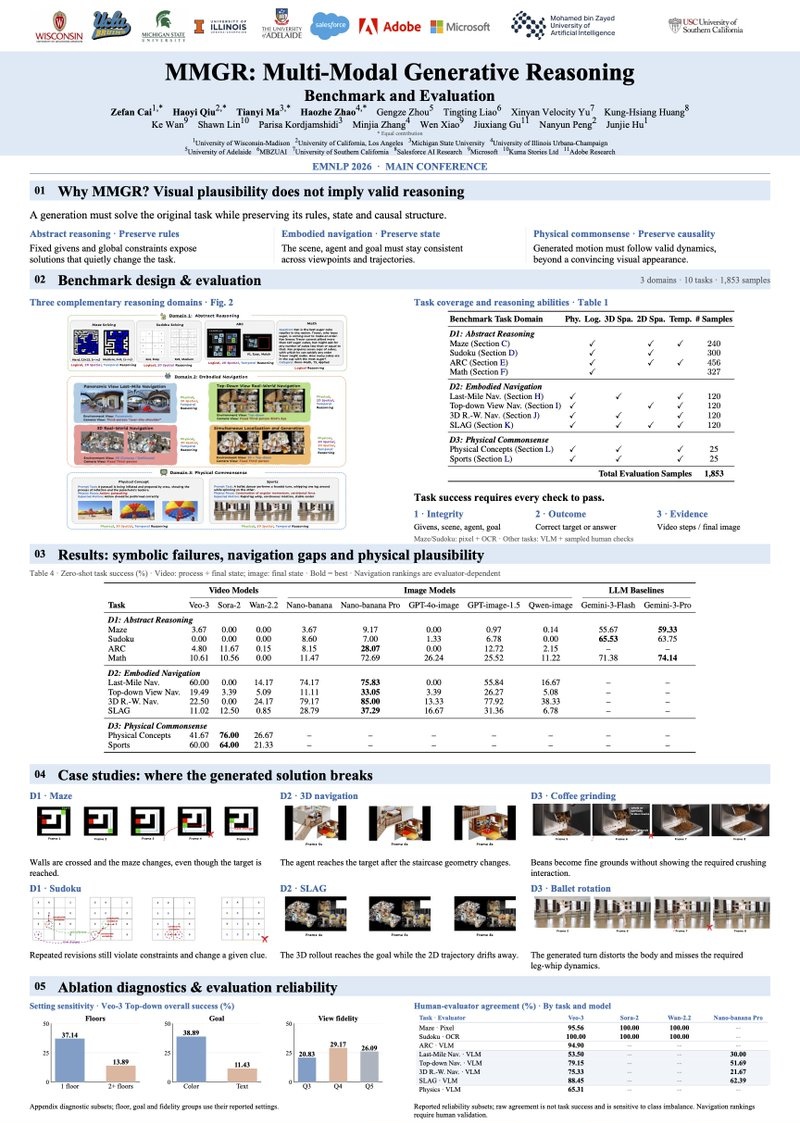
为系统性检验这一关键问题,研究团队正式推出MMGR(Multi-Modal Generative Reasoning Benchmark and Evaluation,多模态生成推理评测基准)——首个聚焦生成式AI推理能力的跨模态统一评测框架,覆盖视频、图像及语言-视觉联合系统。
MMGR涵盖抽象推理、具身导航、物理常识三大核心领域,共设计10项结构化任务;全面评估五类基础推理能力:物理推理、逻辑推理、二维空间推理、三维空间推理与时序推理。
该基准强调‘答案可核验性’,尤其针对视频生成提出创新评估范式——帧链推理(chain-of-frame reasoning):要求中间帧不仅是视觉连贯的过渡,更需构成逻辑上通向目标状态的有效推理步骤,杜绝‘画面顺滑、推理断裂’的伪合理性。
实证测试表明,当前主流视频生成模型、图像生成模型及大语言模型/视觉大模型在MMGR上表现分化显著:模型视觉输出质量与其推理正确率之间存在明显断层。其中,视频模型在物理常识类任务中相对稳健,但在数独求解、ARC抽象推理、数学符号推理等任务上准确率偏低;在跨视角具身导航场景中,响应稳定性亦明显不足。