SpaceXAI发布Grok 4.7:专为编程与知识工作优化的高性能大模型
SmartHey9月22日消息,SpaceXAI今日正式推出新一代大语言模型Grok 4.7,聚焦编程开发与专业级知识工作场景,旨在提升复杂任务处理效率与可靠性。
官方介绍称,Grok 4.7基于全新升级的更大规模基础模型架构,并经过更长时间、更深度的强化学习训练,显著增强其在长程推理、多步代码生成及跨文档知识整合等高阶任务中的表现。该模型被定位为SpaceXAI当前最强的编码与知识处理模型——同等性能下成本降低50%,推理速度提升达100%。
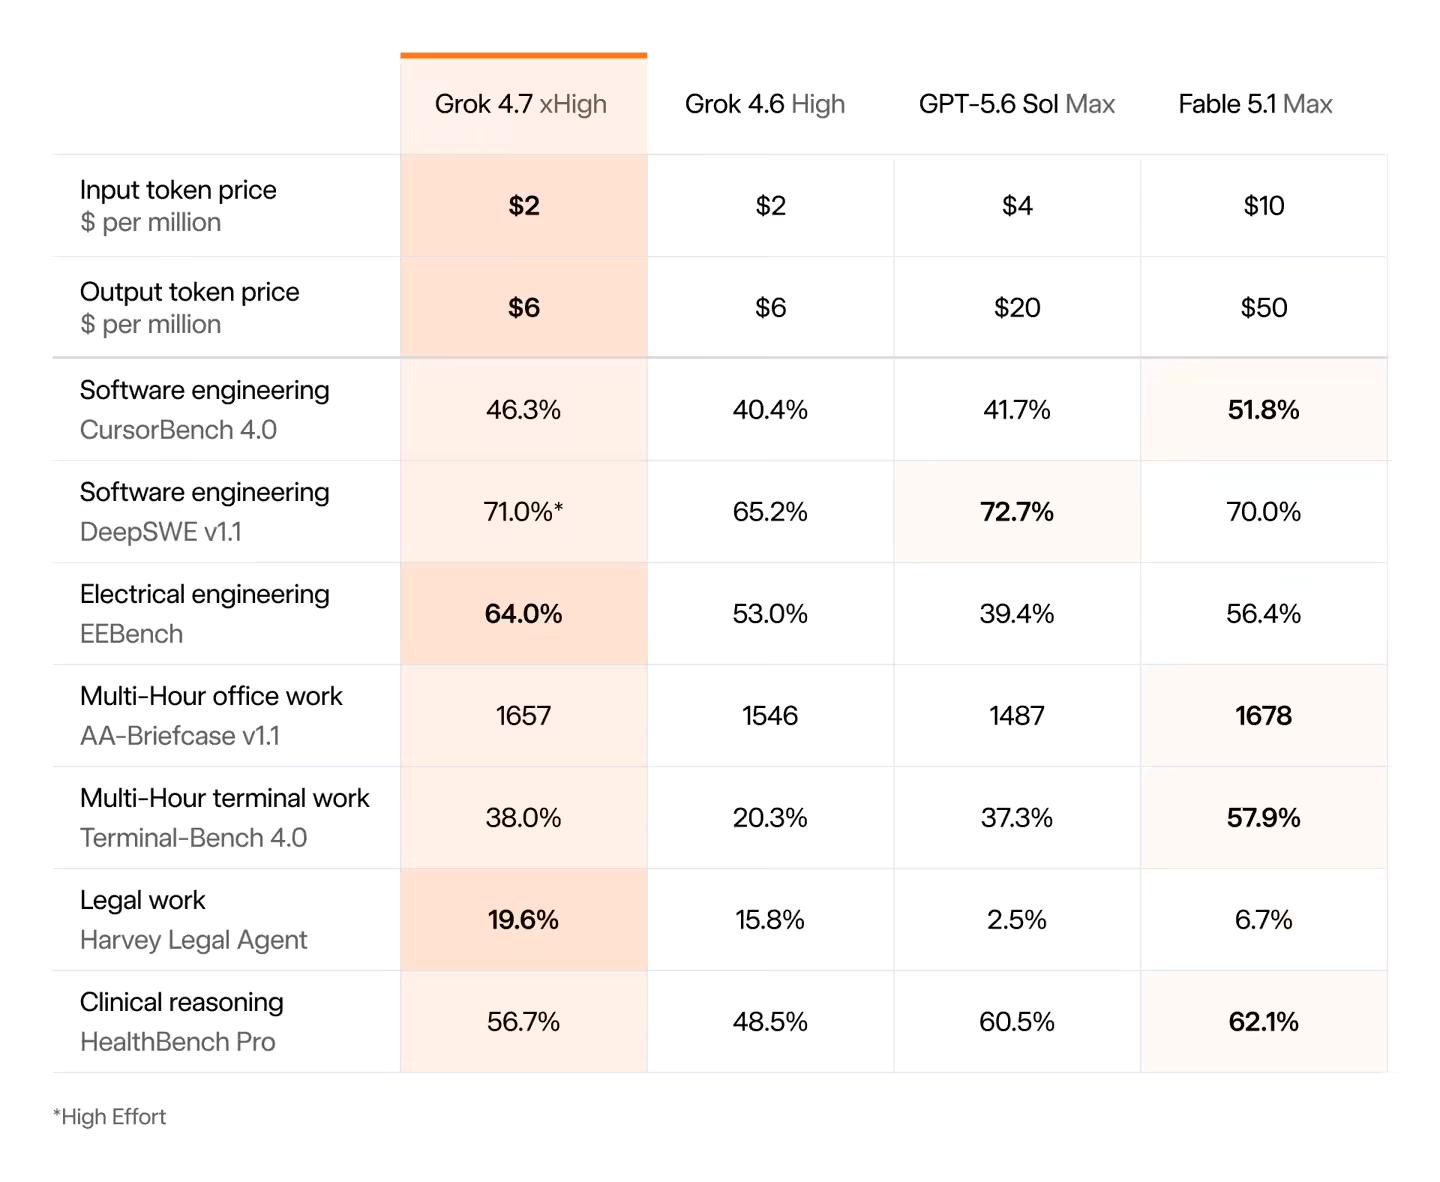
相较于前代Grok 4.6,Grok 4.7在编程稳定性、自我验证能力及长上下文理解方面实现系统性增强:能持续处理难度更高的编程任务,并主动对自身输出进行逻辑校验与错误回溯,降低幻觉与低效迭代风险。
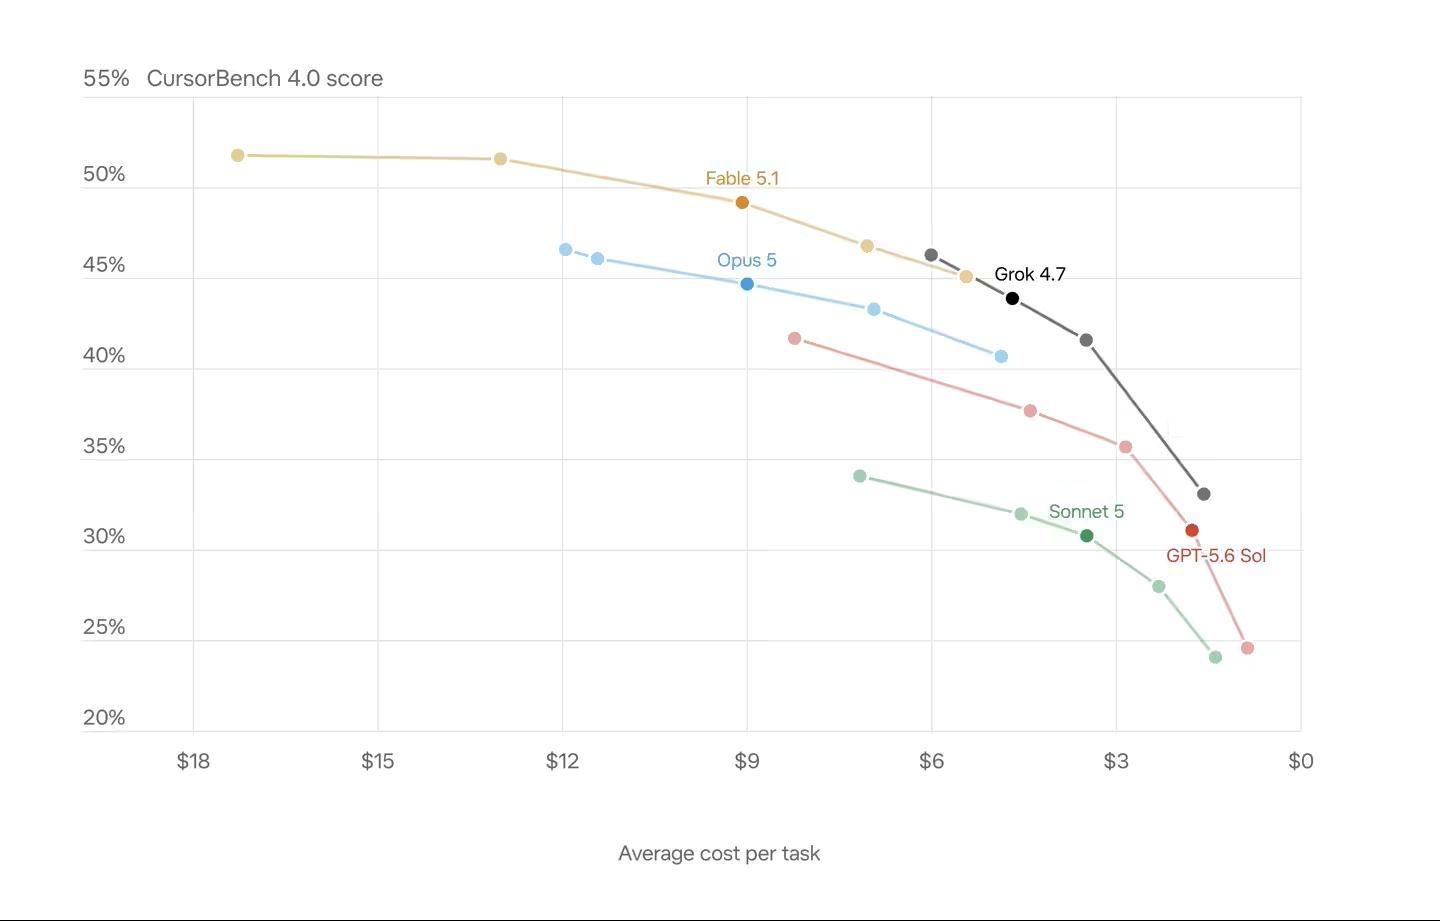
在权威编程基准CursorBench 4.0中,Grok 4.7在长时间运行类编程任务(如全栈功能实现、调试修复链路)的性价比维度位居同类模型前列;值得注意的是,其API调用延迟与单位价格维持与Grok 4.6一致,性能跃升未带来额外使用成本。
训练策略上,Grok 4.7采用更大参数量的基座模型,并重点强化数小时级复杂任务的数据覆盖,同时针对性优化模型的自我验证机制与超长上下文(支持256K tokens)管理能力。
此外,SpaceXAI还针对Grok Bot harness框架完成原生适配训练,显著提升其在自然对话交互、结构化知识检索、多源信息摘要等通用知识任务中的响应质量。在文档撰写、PPT大纲生成及技术方案草拟等办公场景中,亦展现出更强的格式理解力与行业术语准确性。
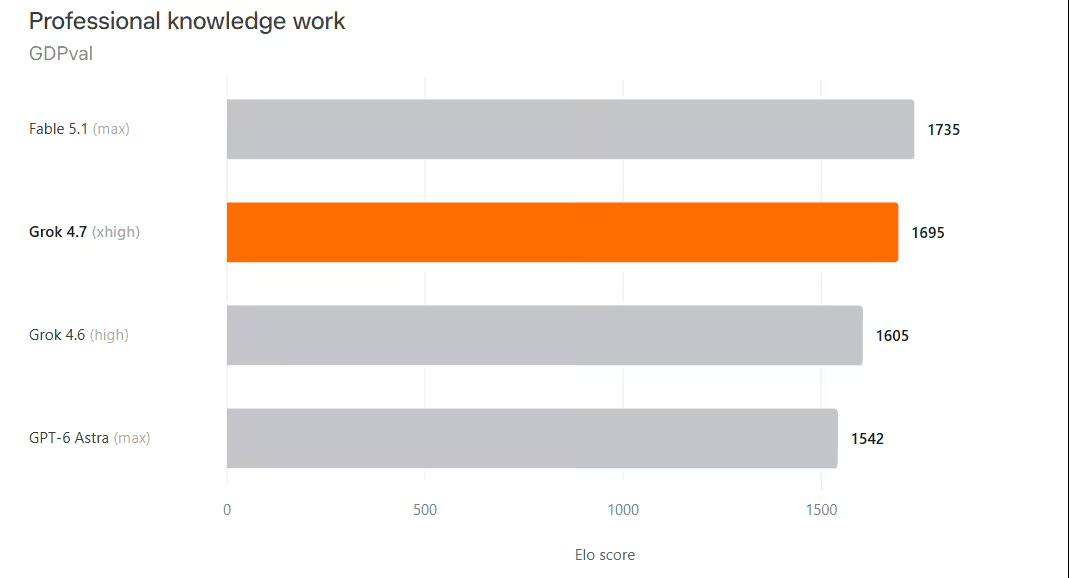
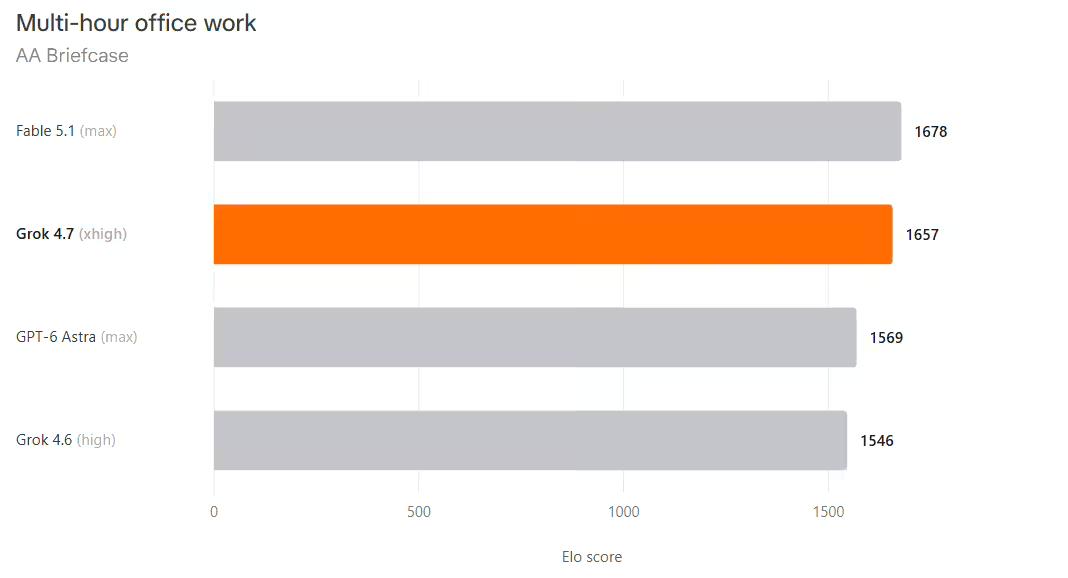
在面向专业领域的GDPval与AA Briefcase两项高难度基准测试中,Grok 4.7相较Grok 4.6取得稳定提升。这两项测试模拟律师合同审查、护士临床决策支持、金融分析师财报归因等真实职业任务,结果显示Grok 4.7已达到与当前主流前沿模型相当的专业胜任水平。
安全层面,Grok 4.7集成全新一代多层防护体系,在拒答率与抗越狱攻击能力上创下SpaceXAI内部测试新高。
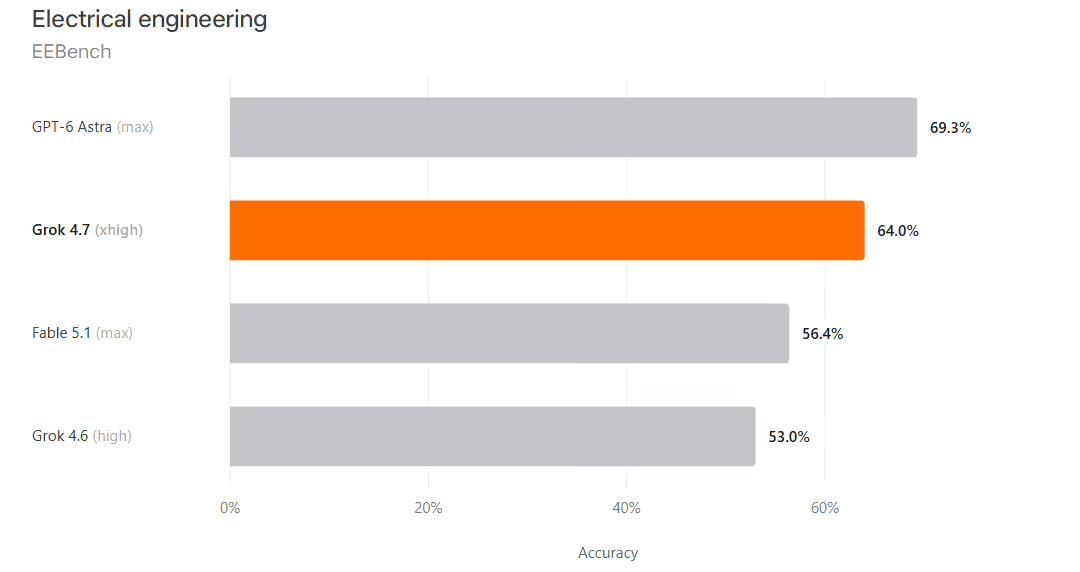
针对网络安全、合成生物学等具有双重用途(dual-use)的敏感领域,模型在保障合法专业需求可用性的同时,大幅提升对高风险指令的识别与拦截精度。在LatchBio生物安全专项评估中,Grok 4.7取得62.4%的安全合规得分;在HackerBench v0.3网络安全压力测试中,仅3.3%的高危双重用途提示成功绕过防护,且对常规渗透测试、漏洞分析等合法安全工作的误阻率显著低于前代。
目前,Grok 4.7已全面上线Cursor IDE与Grok Build开发平台,并开放标准化Grok API,兼容主流第三方编程工具链、模型路由中间件及公有云服务(如AWS Bedrock、Azure AI Studio)。
定价方面,Grok 4.7按token计费:输入起价2美元/百万tokens,输出起价6美元/百万tokens;同步提供‘Turbo’高速版本,输出吞吐量翻倍,对应价格亦为标准版两倍。