OpenAI正式开放GPT-Live-1.1语音API,支持全双工实时交互与后端模型协同推理
SmartHey11月20日消息,OpenAI今日正式向全球开发者开放GPT-Live-1.1语音模型API,赋能第三方应用构建具备实时聆听、动态响应与复杂任务执行能力的AI语音智能体。
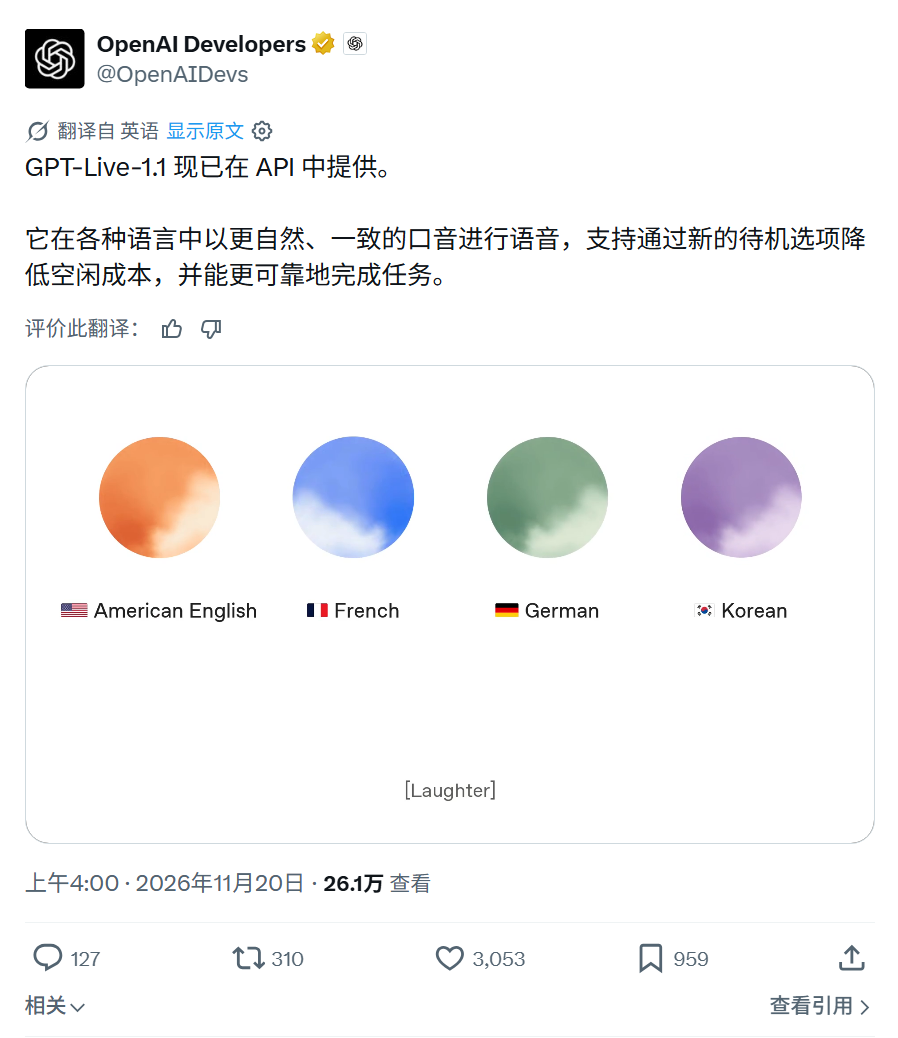
作为GPT-Live-1的增强版本,GPT-Live-1.1采用全双工语音交互架构,可同步接收语音输入并生成自然语音输出,无需等待用户说完即可启动理解与响应。模型能精准捕捉语句中的停顿、中途打断及语速变化,自主判断“继续倾听”或“即时回应”的最佳时机,显著提升对话流畅度与拟人性。
该模型自2026年10月15日起已作为ChatGPT Plus及更高阶订阅用户的默认语音引擎投入使用;此次API开放,标志着其核心能力正式面向生态开发者全面释放。
在性能层面,GPT-Live-1.1大幅优化了多语言语音识别鲁棒性、指令理解准确性与合成语音保真度,尤其强化对字母、数字、代码片段等高精度信息的识别能力,有效降低语音交互中的误读与歧义。
值得一提的是,模型支持“任务委托”机制:当遇到需深度推理、外部工具调用或长流程处理的请求时,可将任务无缝转发至开发者指定的后端模型——既可选用OpenAI提供的大模型服务,也可集成自研或第三方推理引擎。整个过程中,前端语音对话持续进行,交互不中断、体验无割裂。
这一设计使语音智能体真正实现“边说边想、边听边做”,例如在用户语音提问的同时,后台已启动数据库查询、日程调度或代码生成等操作,大幅提升复杂工作流的自动化水平。
依托原生音频端到端处理能力,GPT-Live系列跳过传统语音系统中STT(语音识别)、LLM(大语言模型)和TTS(语音合成)分阶段串联的冗余链路,显著压缩端到端延迟,为实时语音交互提供底层架构保障。
目前,OpenAI已在开发者平台上线GPT-Live-1.1的完整技术文档、快速接入指南及示例代码,开发者可便捷评估模型能力、完成环境配置并启动集成开发。