Claude Fable 5.1 与 GPT-6 Astra 挑战挪威门萨图形推理测试,连续7次斩获满分151分
SmartHey9月28日消息,近日,在美国记者 Maxim Lott 主理的 TrackingAI 智能评估榜单中,Claude Fable 5.1 与支持多模态看图作答的 GPT-6 Astra 在挪威门萨(Mensa Norway)标准图形推理测试中表现惊人——该测试含35道抽象图形题,限时25分钟,二者均实现零失误,连续7轮稳获满分151分。
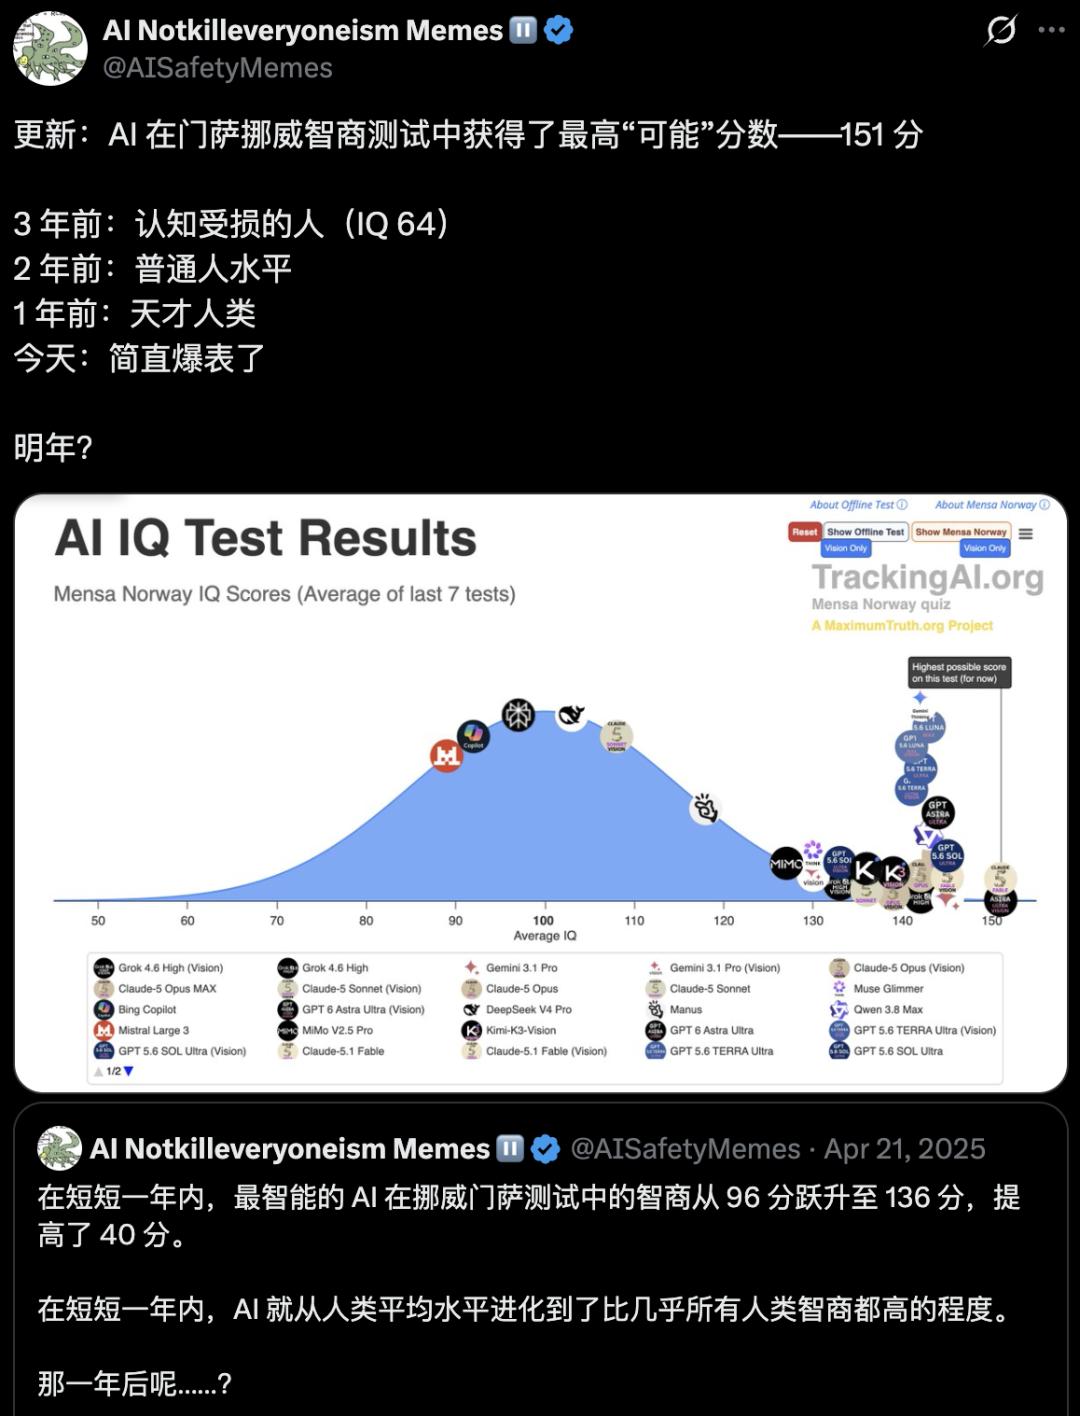
同期,GPT-5.6 Sol 与 Gemini 3.1 Pro 均取得145分;目前公开卷中突破140分的AI模型已形成密集梯队,多个国产大模型亦跻身第一阵营。
此类矩阵推理题由英国心理学家约翰·瑞文于1936年首创,因其高度依赖抽象模式识别与逻辑迁移能力,被公认为衡量综合认知水平最可靠的标准化题型之一。2024年初,Gemini Advanced 在门萨测试最基础的第1题上仍会误用代数式「A+B=C」强行解释图形关系;部分模型仅答对6题,得分低至64分。
关键转折发生在2024年9月:OpenAI 推出的 o1 模型首次实现「内部链式推理→再输出答案」的双阶段响应机制,使其分数跃升至120分以上;此后,“先思后答”成为全球主流旗舰模型的标配能力,整体得分持续攀升——今年4月,榜单首次出现151分的满分纪录。
有人质疑高分是否源于“刷题”?为验证泛化能力,Lott 于2024年5月特邀一名门萨会员独立命制一套全新试题,全程未上传网络、未公开任何题目。换用保密卷后,刷题效应显现明显:部分模型成绩骤降二十分左右。
但头部模型面对完全陌生的16题保密卷,依然逼近极限——该卷理论最高分为约136分,OpenAI 的 GPT-5.6 Terra 看图版已达到135分;Claude Fable 5.1 与 GPT-6 Astra 各得130分;值得注意的是,一支国产模型同样稳定位列该梯队前列。
回溯去年10月,Lott 曾预判:AI 至少还需两年,方能在门萨看图版测试中达成满分。而现实远超预期——不到一年,GPT-5.6 Terra 已疾驰至满分线前,比其预测提前逾一年实现突破。