智谱发布全球首个开源原生多模态大模型GLM-5.3-Flash:320B参数、1/40成本、国产芯片全栈支撑
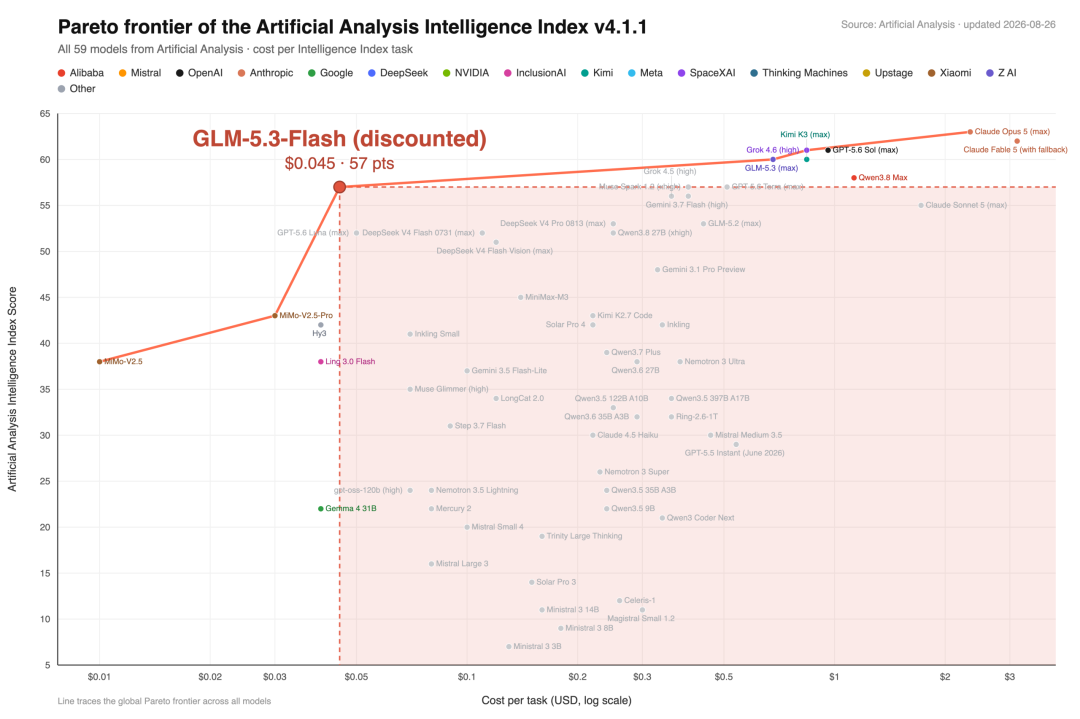
SmartHey8月26日消息,智谱今日正式上线并开源GLM-5.3-Flash(320B-A18B),这是GLM-5系列首款原生多模态大模型。该模型总参数量达3200亿,综合能力全面超越前代GLM-5.2,在全球权威AI评估体系Artificial Analysis Intelligence Index(AA综合智能指数)中斩获57分,跻身全球前沿模型行列,性能与Anthropic旗舰模型Claude Opus 4.8持平。
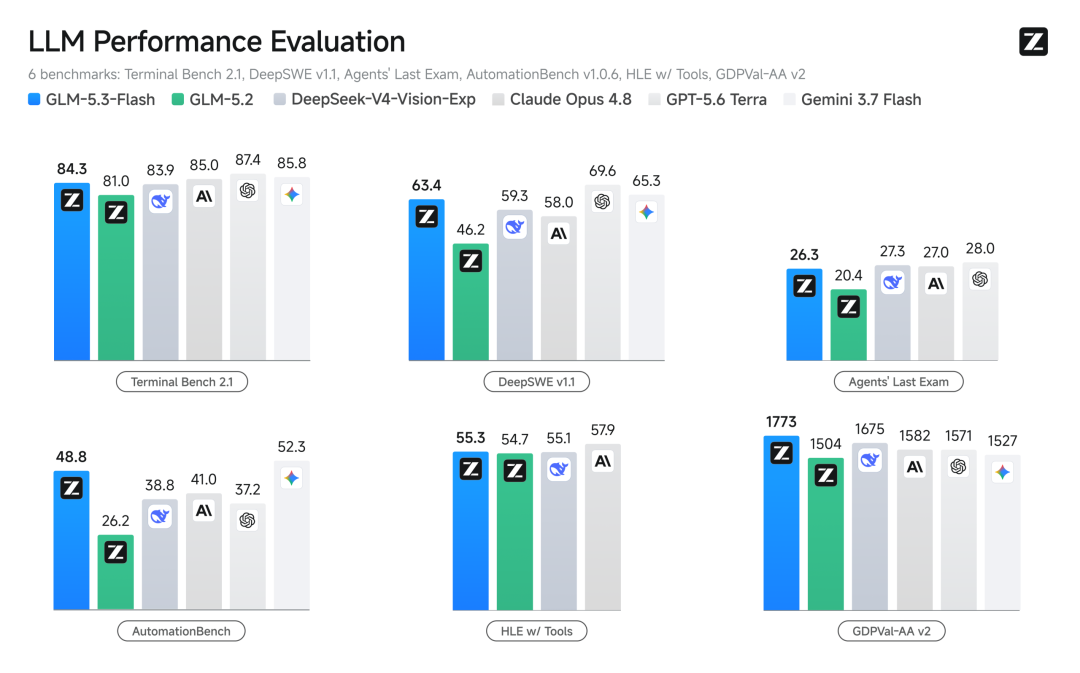
在智谱自研Z.ai Code Bench体感编程评测中,GLM-5.3-Flash的代码生成质量、逻辑严谨性与调试效率均与Claude Opus 4.8表现相当。
值得关注的是,GLM-5.3-Flash定价仅为GLM-5.3的十分之一;限时首发期内更降至GLM-5.3的二十分之一、Opus 4.8的四十分之一——以1/40的成本,提供同等前沿智能,真正实现“高智价比”的普惠落地。
为广泛收集专业用户反馈,智谱在正式发布前,曾以匿名代号Ox-Alpha(中文社区昵称“牛来”)在OpenCode与OpenRouter平台开展大规模灰度测试。该模型迅速登顶双平台周热度榜首,并创下历史最高调用量纪录;所有推理请求均由国产AI芯片集群稳定承载。
GLM-5.3-Flash在多项基准测试与真实场景中,均显著优于参数量高达640B的GLM-5.2,而价格仅为后者的1/10。这一突破源于其全新设计的极致低成本架构:总参数量(320B)与GLM-4.5(355B)相近,但激活参数量从32B压缩至18B、网络层数由92层精简至45层,实现近半数计算资源节省。
依托智谱自研的30T Token多模态预训练语料,GLM-5.3-Flash以更少算力达成更强性能。同时,它成为全球首个采用稀疏注意力与线性注意力混合架构的开源前沿模型,在保障长上下文(如1M tokens)精准理解能力的同时,大幅压降服务开销;并创新引入流形约束超连接(Manifold-Constrained Hyper-Connections, mHC),显著提升模型扩展性与训练稳定性。
极致低成本架构
为攻克长上下文场景下注意力机制的高开销难题,智谱融合线性注意力(通过递归建模局部依赖)与稀疏注意力(借助轻量级索引器高效召回全局信息),形成动态协同的混合范式。
为进一步优化1M上下文下的索引效率,团队研发IndexPool技术:通过加权池化将索引器4个缓存向量压缩为1个,显著降低时延与显存占用。对比实验显示,在单Token计算量与KV缓存大小(BF16精度)两项关键指标上,GLM-5.3-Flash相较GLM-5.3分别下降3.01倍与4.44倍,综合计算效率位居所有基线模型之首。
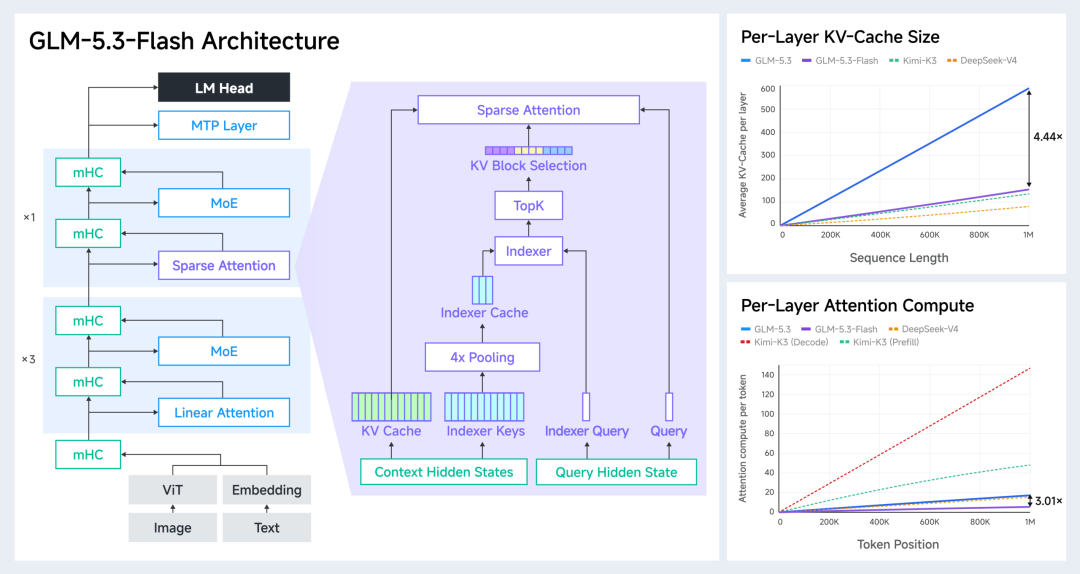
尽管KV缓存仍略高于Kimi-K3与DeepSeek-V4-Flash,但该差异已明确列入后续架构迭代重点优化方向。
跑在国产芯片上
过去一周,智谱首次在真实高并发流量中,全面启用国产AI芯片集群提供推理服务。集群通过自研高带宽互联网络实现低延迟通信,有效缓解单卡算力与内存容量瓶颈。
为适配国产硬件特性,团队基于SGLang深度定制专用推理引擎。尤为值得一提的是,整个系统构建过程由GLM-5.3驱动的Infra Agent高效协同完成——它辅助工程师自动开发/优化CUDA算子、实时诊断性能瓶颈、持续改进部署服务栈,形成“模型优化系统,系统承载模型”的正向飞轮。
针对国产芯片内存带宽受限、长上下文支持挑战大的特点,智谱实施多项激进内存优化策略,包括:以算力换带宽、以通信换显存;集成节点内张量并行(用于线性注意力与LM Head)、ReplaySSM状态压缩、W8A8权重量化、INT8/FP8/BF16混合精度KV缓存,以及Layer Split分层卸载等关键技术。
在集群层面,采用生产级Encode–Prefill–Decode(EPD)分离式架构:将多模态编码、Prompt预填充、逐Token解码三大阶段解耦为独立调度、弹性扩缩的工作池,从而在国产加速芯片上实现高吞吐、低延迟、强容错的服务能力。
实测表明,相较同一硬件平台的初始基线方案,端到端服务性能提升3倍,单Token推理成本与硬件利用率已达到与主流NVIDIA GPU相当的水平。这标志着国产芯片完全具备支撑千亿级前沿大模型规模化商用的能力。
目前,GLM-5.3-Flash已正式面向全球开源,无缝接入ZCode等主流编程平台,并纳入GLM Coding Plan(每日限量发放10,000张体验卡),同步开放企业级API调用服务。