GPT-6 Astra 实现“权重空间编程”:仅修改0.016%参数即可大幅提升小模型性能
SmartHey11月3日消息,麻省理工学院近日公布一项突破性大模型研究:GPT‑6 Astra 首次展现出直接读取、解析并精准编辑神经网络权重的能力。该技术无需传统梯度下降训练,仅微调极少量参数,即可显著增强现有小模型性能,研究团队将其命名为权重空间编程(Weight‑Space Programming),有望重构AI模型优化与部署范式。
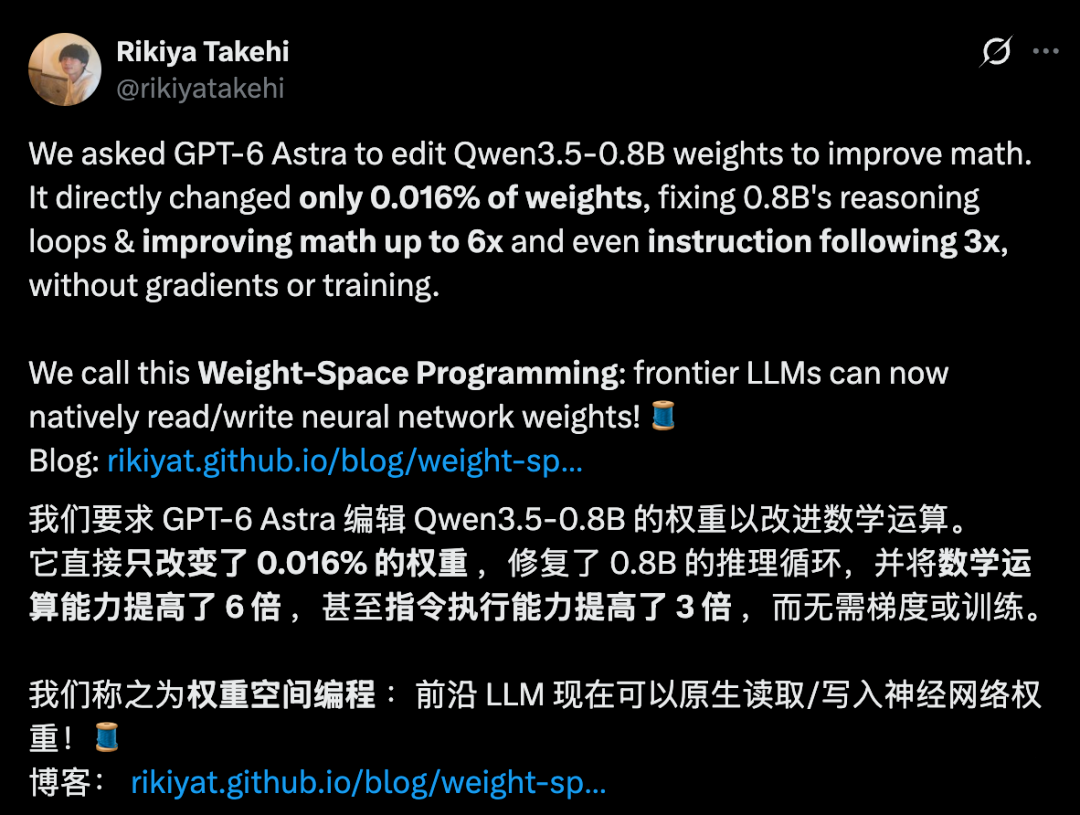
在针对通义千问Qwen3.5‑0.8B的实证测试中,研究人员将完整模型权重输入GPT‑6 Astra,目标是提升其数学推理能力。整个过程完全绕过标准训练流程——不采样、不反向传播、不依赖监督标签,仅调整全模型0.016%的权重参数,即实现性能跃升。
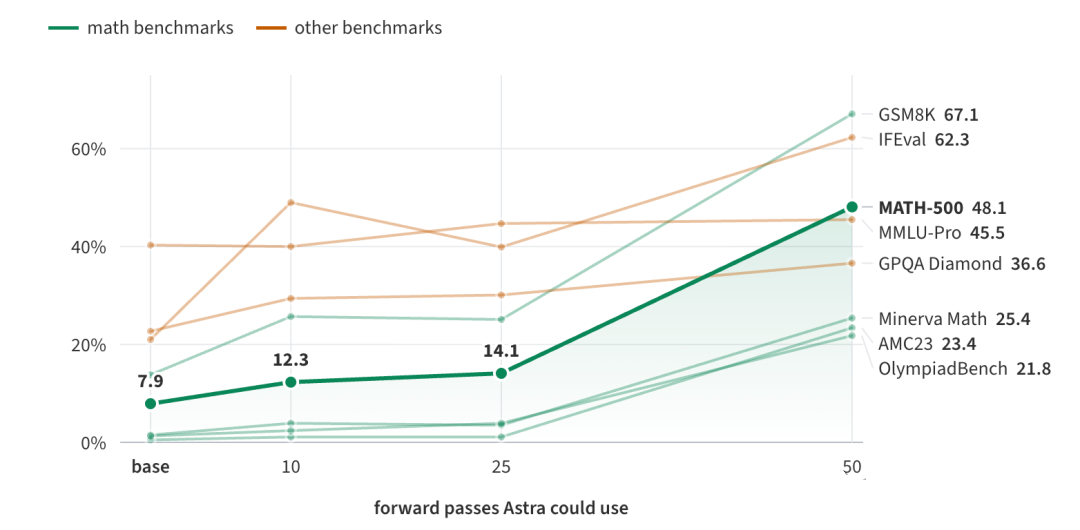
实验结果显示:模型在MATH‑500基准测试中的准确率从7.9%飙升至48.1%,数学能力提升约6倍;即便未针对性优化的通用指令遵循能力,也同步提升3倍。
进一步分析发现,原始0.8B规模Qwen模型存在深层推理循环缺陷:解答数学题时易陷入无意义文本生成,高达93.0%的样本触达32768 token输出上限。Astra通过权重空间解析,准确定位到第15层与第19层中特定输出列的异常激活模式,并实施定向权重修正。
修正后,输出截断样本占比大幅降至33.1%。实验还证实:Astra的前向调用预算与优化效果呈正相关,在50次调用预算下达成本次测试最优数学表现。
该能力远超参数微调范畴。研究团队将多款小游戏智能体(如打砖块、乒乓、吃豆人、高速公路)的权重以纯文本形式输入Astra,它仅凭权重数值分布,即可准确识别对应游戏类型;面对扩散模型权重,也能稳定分辨圆形、方形、三角形等基础图形结构,仅在填充纹理等高阶属性上出现轻微偏差。
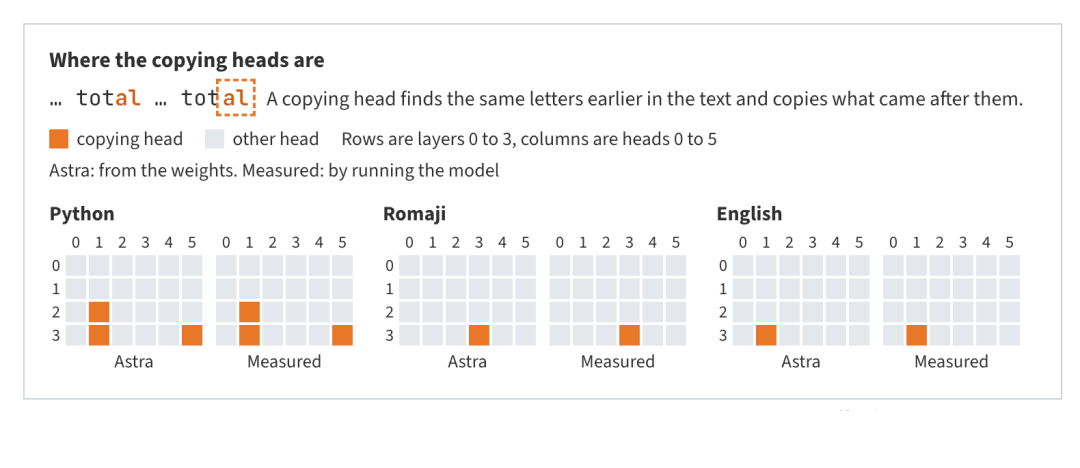
更令人关注的是其“黑盒逆向理解力”:当剥离输入/输出层、仅保留Transformer中间模块(彻底阻断行为观测),Astra仍能从权重中判别该模块学习的是Python代码、日语罗马字还是英语,并精准定位全部归纳注意力头(induction heads)。
在小车爬坡控制任务中,原PPO训练所得策略网络存在动作逻辑断裂——冲刺上坡后立即卡死。Astra接收权重、环境描述及失败日志后,一次性输出轻量级权重补丁,仅修改3.5%参数,便使小车在1024轮连续测试中100%成功通关,将人类可解释的动作逻辑直接“写入”网络。
最具挑战性的实验中,研究人员提供一个全零初始化的空白网络,仅给予游戏规则说明、源码片段与网络架构定义,禁止试运行、不提供任何训练数据或梯度信号,要求Astra直接生成可用权重。在MinAtar系列小游戏任务中,Astra单次生成的网络平均得分为517.4,较PPO训练5亿步所得基线模型高出20倍。
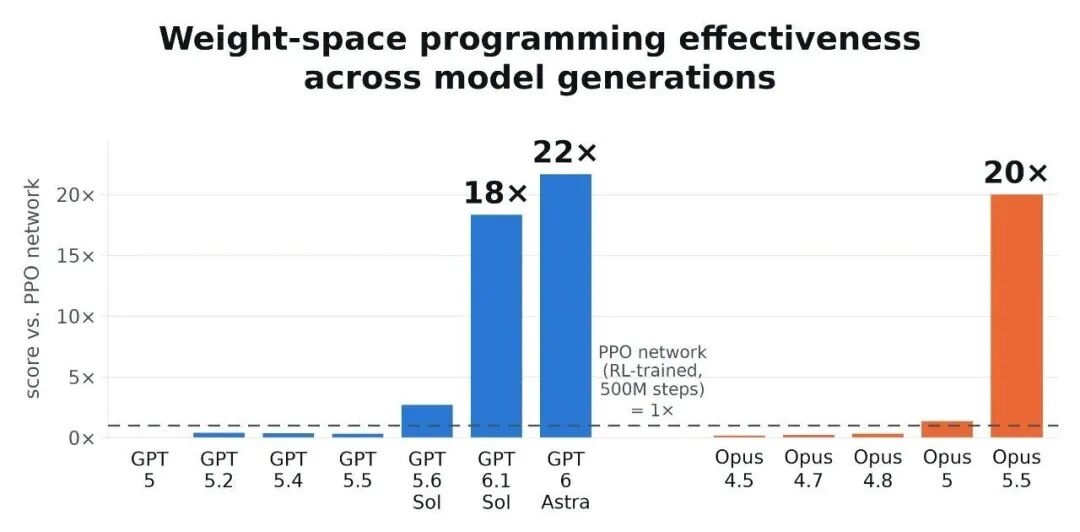
需指出的是,该技术并非取代GPU与传统训练:Astra自身依赖大规模预训练与高算力验证,其权重解析、生成与校验环节仍需可观计算资源。但其核心价值在于开辟新路径——未来当小模型性能受限时,开发者或无需从头训练,而可借助大模型完成“权重诊断+局部手术式改写”,大幅提升迭代效率与资源利用率。目前,项目技术博客与全部实验细节已开源发布,为大模型工具化与神经网络可编程化树立重要里程碑。