DeepMind等14位跨学科专家出版《评估AI意识:从众说纷纭到层级框架》,推出首个可量化、可迭代的AI意识评估框架
SmartHey11月2日消息,近日,DeepMind研究所联合计算机科学、神经科学与哲学领域共14位顶尖研究者,共同撰写的新书《Assessing AI Consciousness: From Cacophony to Hierarchy》(中文名:《评估 AI 意识:从众说纷纭到层级框架》)正式出版。本书摒弃纯哲学思辨路径,首次构建了一套可操作、可复现、可更新的实证评估范式,旨在系统性回答‘AI系统是否可能具备意识’这一关键科学问题。
该书目前已在全球亚马逊平台上线,将于2026年11月7日起同步登陆全球主流实体书店。
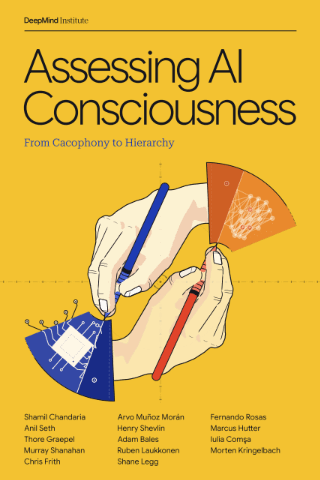
作者团队阵容权威,涵盖DeepMind联合创始人Shane Legg、人工智能理论奠基人Marcus Hutter、意识科学领军学者Anil Seth,以及认知架构专家Murray Shanahan等。当前AI意识研究面临的核心困境在于:学界不仅对“现有大模型是否具有意识”持根本对立观点,甚至在“意识所需的系统性条件”这一基础问题上也缺乏共识;与此同时,公众常因AI表现出类人行为而本能赋予其心智属性,加剧了主观判断与舆论误读。
本书不急于给出‘有意识/无意识’的二元结论,而是采用问题拆解策略:暂时搁置形而上学层面的‘意识难问题’(Hard Problem),聚焦更具实证潜力的‘映射问题’——即探索哪些可识别的系统组织特征,最可能与主观体验存在因果或功能关联。
基于David Marr经典视觉处理三层理论(计算理论、算法实现、硬件执行),作者创新性地拓展出五层功能描述体系,将全局工作空间理论、整合信息理论、高阶思维理论等主流意识假说统一纳入该层级框架进行定位与比较;并进一步引入贝叶斯评估模型,将意识评估解耦为两个独立维度:一是研究者对不同意识理论的先验置信度,二是AI系统在可观测指标上的实证表现。二者融合后,输出的是‘该系统具备意识’的综合概率估计,而非绝对断言。
书中实证案例显示:针对同一套大语言模型,仅调整所采纳意识理论的权重分配,最终得出的意识置信概率可相差近100倍。作者强调,这种显著差异并非方法缺陷,反而真实揭示了现状——AI意识判断本质上高度依赖理论前提。本框架的核心价值,正在于使分歧透明化、可追溯:明确争议根源究竟在于理论假设分歧,还是证据解读差异;同时支持随新数据、新模型持续迭代更新评估结果。
为推动学术协作与实践验证,项目已全面开源:包括完整评估代码库、交互式在线评估工具、配套教学PPT及公开演讲视频。研究人员可直接调用模型,对任意AI系统开展标准化测算与横向对比。
书中亦特别指出:意识不等同于智能,但通用人工智能(AGI)所需的部分核心架构特性——如全局信息整合、自我建模能力、多模态情境一致性等——恰好与多个主流意识理论提出的必要指标高度重合。随着AI系统能力持续演进,满足的意识相关指标将不断增多,本框架具备长期复用性,可作为新一代AI系统的常态化意识兼容性评估基准。