BOSS直聘开源33B旗舰教师模型Nanbeige4.3-33B,聚焦智能体编程与协作办公,开启“大教小”蒸馏新路径
SmartHey10月26日消息,BOSS 直聘(Kanzhun Limited)旗下大模型实验室 Nanbeige(南北阁)通过官方 X 账号 @nanbeige 正式开源 Nanbeige4.3-33B。该模型参数量达 33.1B,采用 BF16 精度,同步发布基座版本 Nanbeige4.3-33B-Base,均已上架 Hugging Face 平台,仓库创建时间戳为 10 月 24 日。
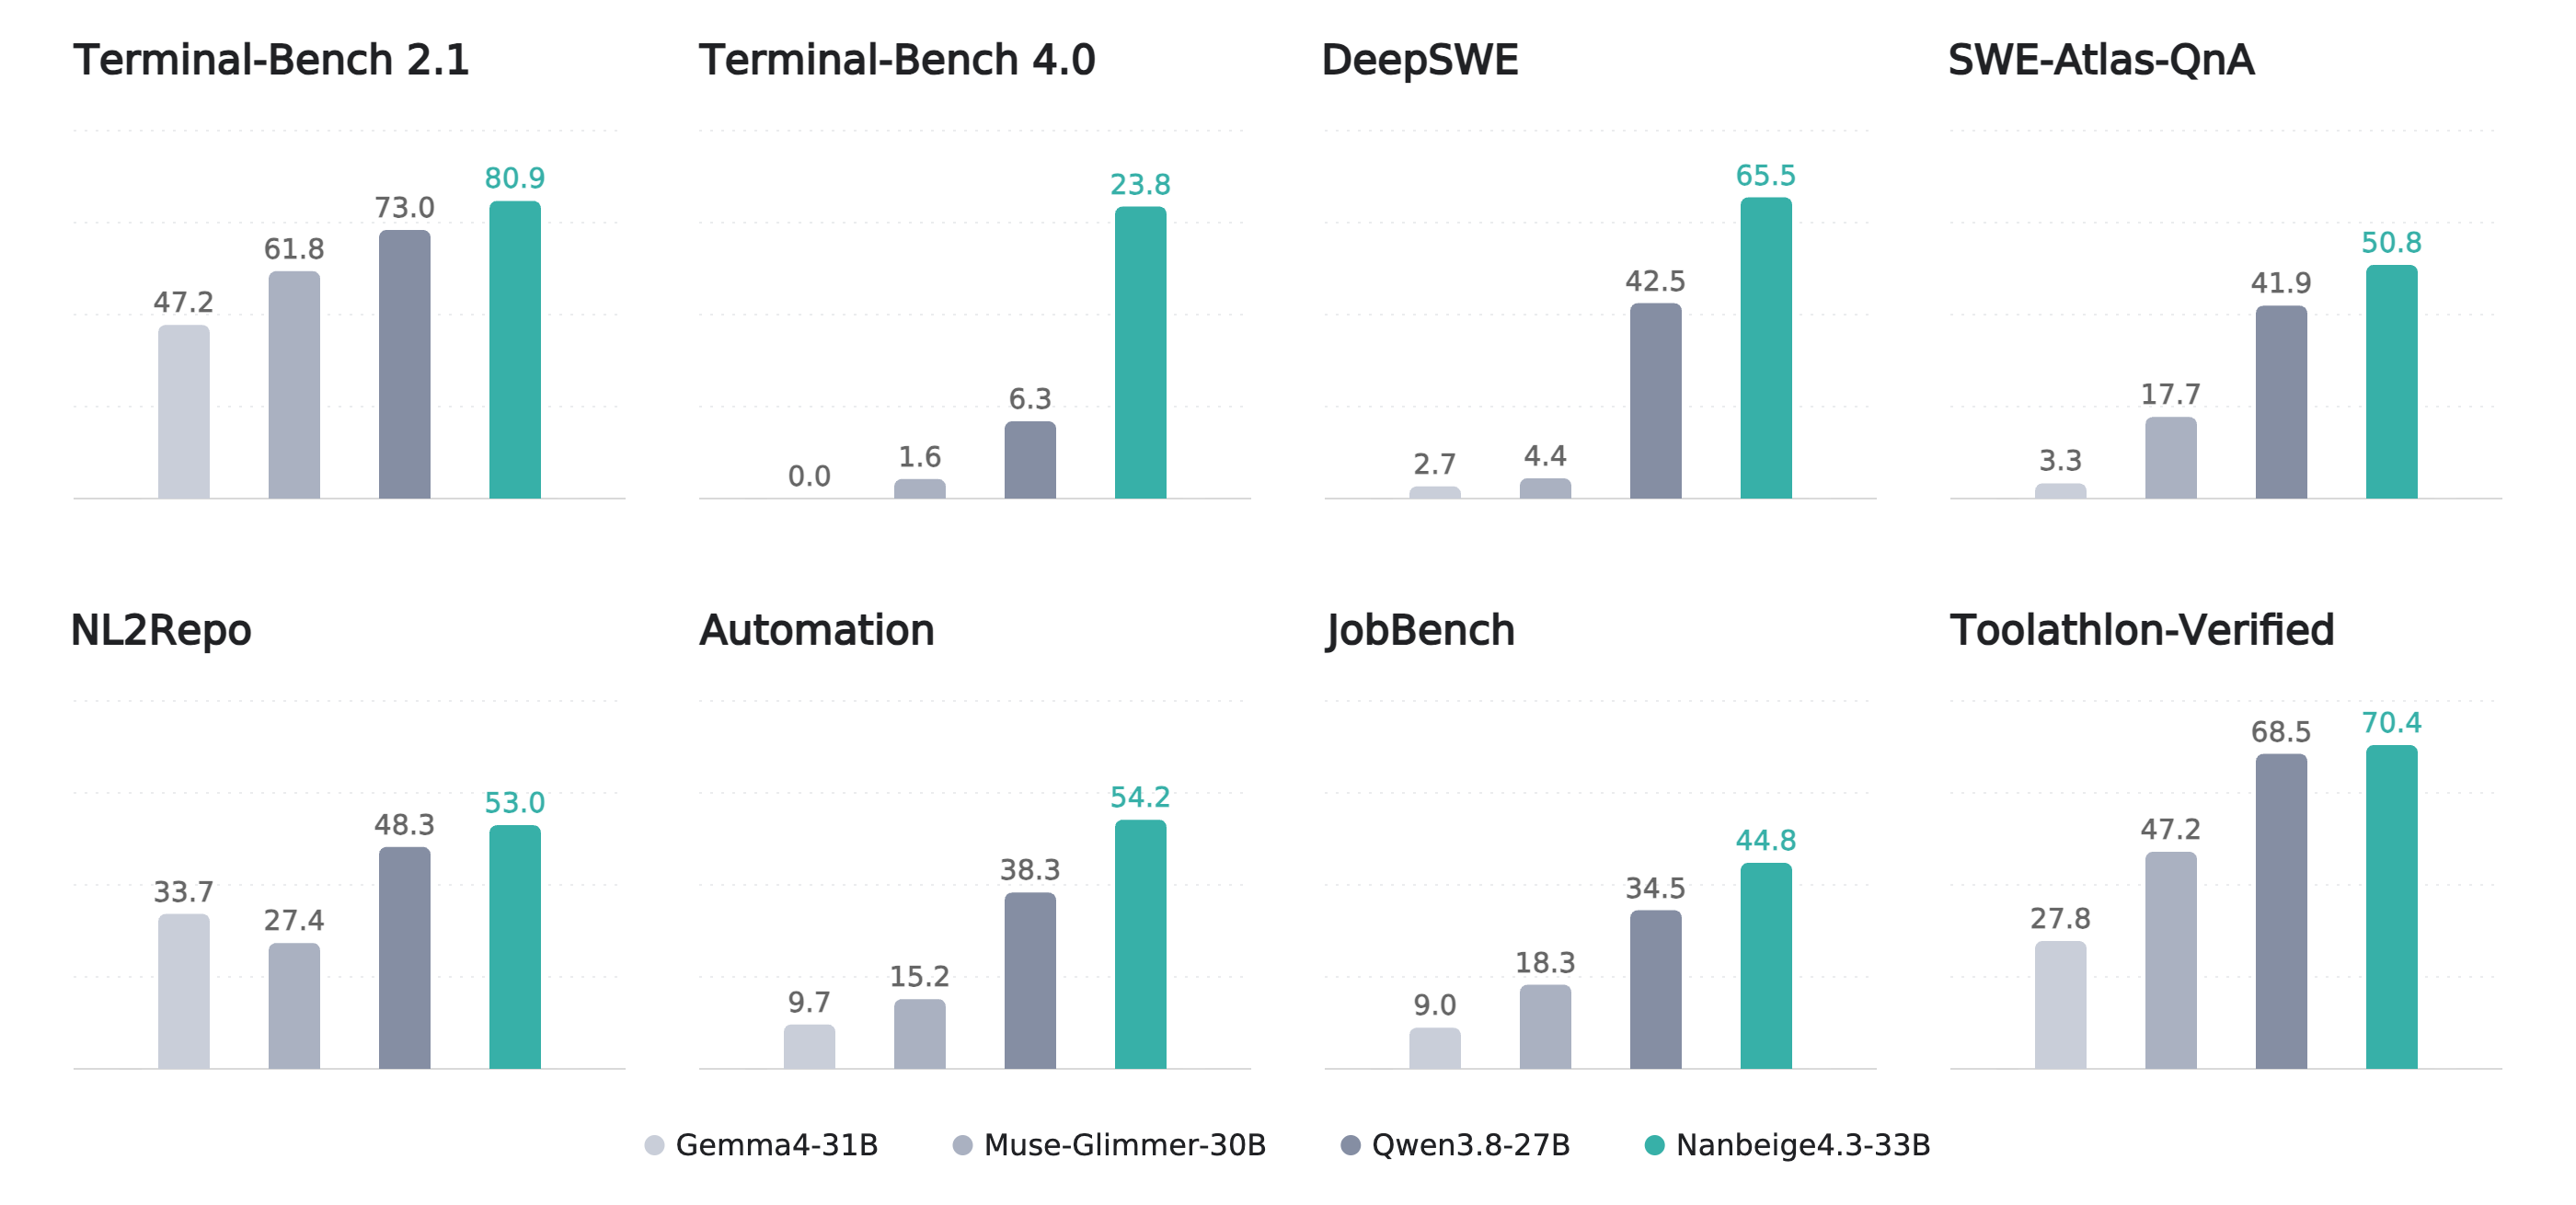
官方介绍指出,Nanbeige4.3-33B 在约 30B 参数规模的开源模型中,于 agentic(自主智能体)能力维度达到当前开源领域 SOTA(最先进)水平,尤其在 agentic coding(智能体编程)与 cowork(协作办公)基准测试中表现突出;在主流 agent harness(智能体运行框架)中部署时,具备显著推理成本优势。
发布策略明确:该 33B 模型被定位为「教师模型」,将作为知识蒸馏(distillation)的核心锚点,用于指导后续更轻量级模型的训练——首个学生模型即为即将推出的 Nanbeige4.3-3B。
截至检索时,该开源公告帖文获得约 18.7 万次浏览、1,700 余次点赞、201 次转发及 160 次引用。所有基准成绩与 SOTA 判断均出自 Nanbeige 团队自评;可独立验证的事实包括:两个模型仓库真实存在,模型卡所列配置、评估表格与技术说明完整且可查。
先建教师,再炼学生:Nanbeige4.3 的双阶段演进逻辑
模型卡清晰阐明了 4.3 系列的技术路线:以高容量、强泛化能力的教师智能体为起点,系统性地将 agentic 行为能力蒸馏至小模型。Nanbeige4.3-33B 即是这一路线下的旗舰教师模型。
-Base 版本同步开放,定位为通用智能体开发的起点——既支持直接构建通用 agent,也适合作为领域专用 agent 的再训练基座。其模型卡将 Gemma4-31B-Base 作为唯一对比对象,并称其为「过去半年内 30B 参数档唯一发布的前沿开源基座模型」,该表述同样源自发布方。
在涵盖 MMLU-Pro、GPQA、SuperGPQA、GSM8K、Math、MBPP、MMLU、CMMLU 共 8 项权威基座能力基准中,Nanbeige4.3-33B-Base 全面领先:GPQA(62.0 vs 41.5)、Math(57.3 vs 43.6)、CMMLU(86.8 vs 76.9)等关键指标优势显著。
自评成绩单:20 项智能体基准中 17 项登顶,短板集中且差距微小
模型卡将 Nanbeige4.3-33B 与 Qwen3.8-27B、Muse-Glimmer-30B、Gemma4-31B 三款近期同档位前沿模型横向对比,所有测试均在统一推理档位、超参数与评测框架下完成。评测覆盖 agentic coding、agentic cowork 和通用推理三大类共 20 项任务,Nanbeige4.3-33B 在其中 17 项位列第一。
优势最明显的是智能体编程方向:Terminal-Bench 2.1 得分 80.9(第二名 Qwen3.8-27B 为 73.0),Terminal-Bench 4.0 达 23.8(Qwen3.8-27B 仅 6.3,Gemma4-31B 为 0.0),DeepSWE 为 65.5(Qwen3.8-27B 为 42.5)。协作办公方面,Automation Bench(54.2 vs 38.3)与 DeepPlanning(63.3 vs 49.2)亦大幅领先。
三项落后指标为:SWE-Bench Pro(Qwen3.8-27B 61.7 vs Nanbeige 60.3)、GDPval(Qwen3.8-27B 86.4 vs Nanbeige 84.8)、GPQA Diamond(Gemma4-31B 91.3 vs Nanbeige 89.5);另两项 Tau3-Bench(48.8 vs 48.5)与 EnterpriseOps-Gym(41.0 vs 40.2)差距均不足 1 分。
评测细节注明:Terminal-Bench 2.1 基于 Terminus 2 框架;Terminal-Bench 4.0 与 DeepSWE 使用 mini-swe-agent v2.4.6;NL2Repo 在 Claude Code 中执行;SWE-Atlas-QnA 依据 1,304 条任务细则,由 GPT-6 Sol 担任判分模型;YC-bench 更以美元计价,Nanbeige4.3-33B 录得 $1,025,437(Qwen3.8-27B 为 $641,290)。
职业粒度拆解:技术与内容岗全面领跑,医疗与客服岗仍有提升空间
JobBench 测试按 35 个细分职业展开:Nanbeige4.3-33B 总分 44.80,显著高于 Qwen3.8-27B(34.51)与 Muse-Glimmer-30B(16.60),团队称其在「多数职业场景中超越基线」。
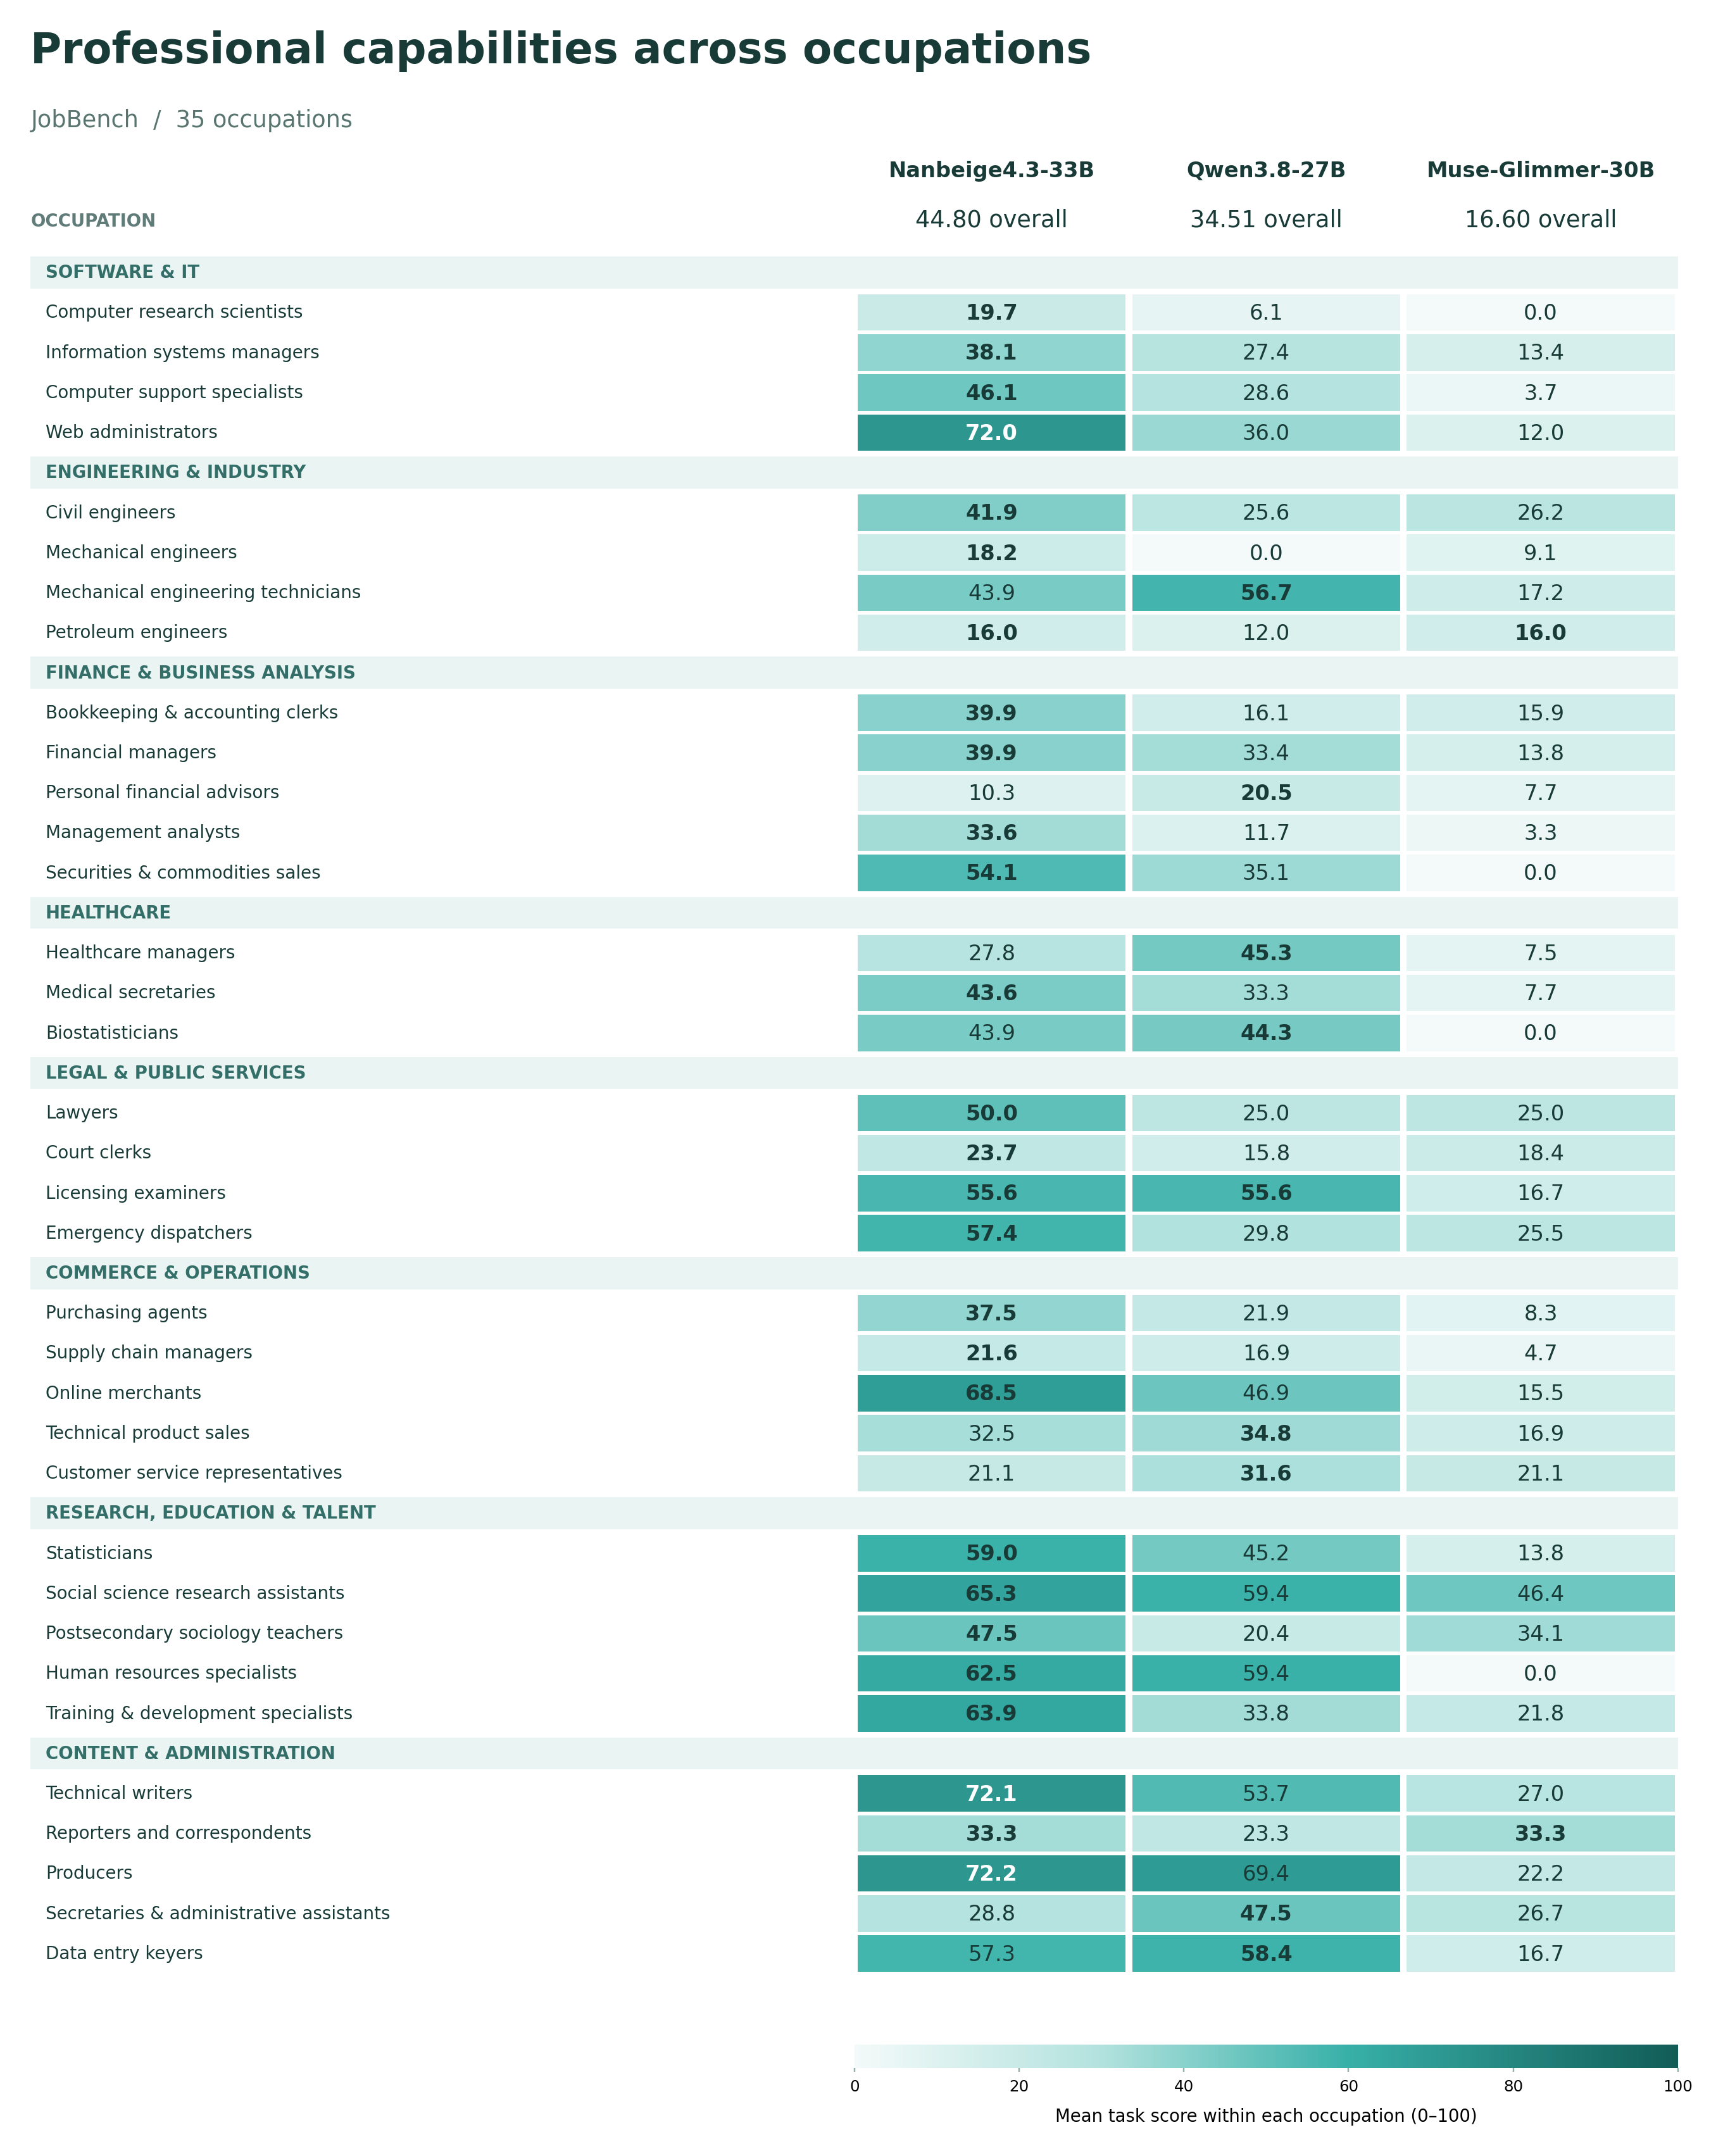
领先岗位集中于技术与内容生产类:Producers(72.2)、Technical writers(72.1)、Web administrators(72.0)、Online merchants(68.5)。相对弱势岗位包括:Healthcare managers(27.8 vs Qwen 45.3)、Secretaries & administrative assistants(28.8 vs 47.5)、Customer service representatives(21.1 vs 31.6);Data entry keyers(57.3 vs 58.4)为唯一小幅落后项。
512K上下文 + XML工具调用:面向生产部署的工程优化
模型卡明确支持最长 524,288 token(即 512K)上下文长度。聊天模板提供三项关键开关:enable_thinking 控制单轮推理生成;preserve_thinking 决定多轮对话中是否保留历史思考链(推荐问答设 False,工具调用/办公/代码工作流设 True);tools 参数启用工具调用模板,官方推荐 tool_call_format="xml" 以获得最佳效果(JSON 保留兼容);全部自评成绩均基于 preserve_thinking=true 配置测得。
推理参数建议分两档:agentic 与工具任务使用 temperature=1.0、top_p=0.95、max_new_tokens=65536;通用推理与聊天任务则用 temperature=0.6、max_new_tokens=262144。
部署示例覆盖 Transformers、SGLang 与 vLLM,其中 SGLang 与 vLLM 启动命令均按 4 卡张量并行配置;推理解析器采用 qwen3,工具调用解析器采用 qwen3_coder。关于「接入主流 agent harness 时推理具有成本效益」的声明,帖文与模型卡未披露具体吞吐量或单位成本数据。仓库附联系方式 nanbeige@kanzhun.com,欢迎在数据共建、训练协同及领域专用 agent 开发等方面开展合作。
从3B起步的开源实践者,首次亮出33B教师模型
Hugging Face 组织页显示,Nanbeige 是 BOSS 直聘专注大模型研发的实验室,团队共 19 人,已公开上线 13 个模型。历史模型以 3B 档为主:今年 3 月发布的 Nanbeige4.1-3B(配套论文《Nanbeige4.1-3B: A Small General Model that Reasons, Aligns, and Acts》)、2025 年 12 月的 Nanbeige4-3B-Thinking-2511,以及 9 月 11 日更新、下载量达 11.6 万次的 Nanbeige4.2-3B(当前可见列表中下载量最高)。本次 Nanbeige4.3-33B 的发布,是该实验室首次开源 33B 级别模型;按官方规划,它并非终点,而是通向 Nanbeige4.3-3B 的关键桥梁。
仓库讨论区已出现实际需求:用户 leran1995 提议发布 FP8 量化版本,并询问技术报告进展。而 Nanbeige4.3-3B 尚未出现在 Hugging Face 可见模型列表中,蒸馏时间表亦未公布;其能否有效继承教师模型的 agentic 能力,有待后续独立基准测试验证。