英伟达联合vLLM推出CuTe DSL定制解码链路,Kimi K3在GB300上解码吞吐提升1.8倍
SmartHey10月19日消息,英伟达工程师于当地时间10月16日在vLLM官方博客发布技术文章,宣布基于Agent辅助开发,在英伟达GB300(Blackwell架构)硬件平台上构建专用CuTe DSL解码链路,成功对2.8T参数的Kimi K3大模型完成深度优化,显著提升解码吞吐量与交互延迟表现,并通过一项创新的上游vLLM协同优化方案实现工程落地。
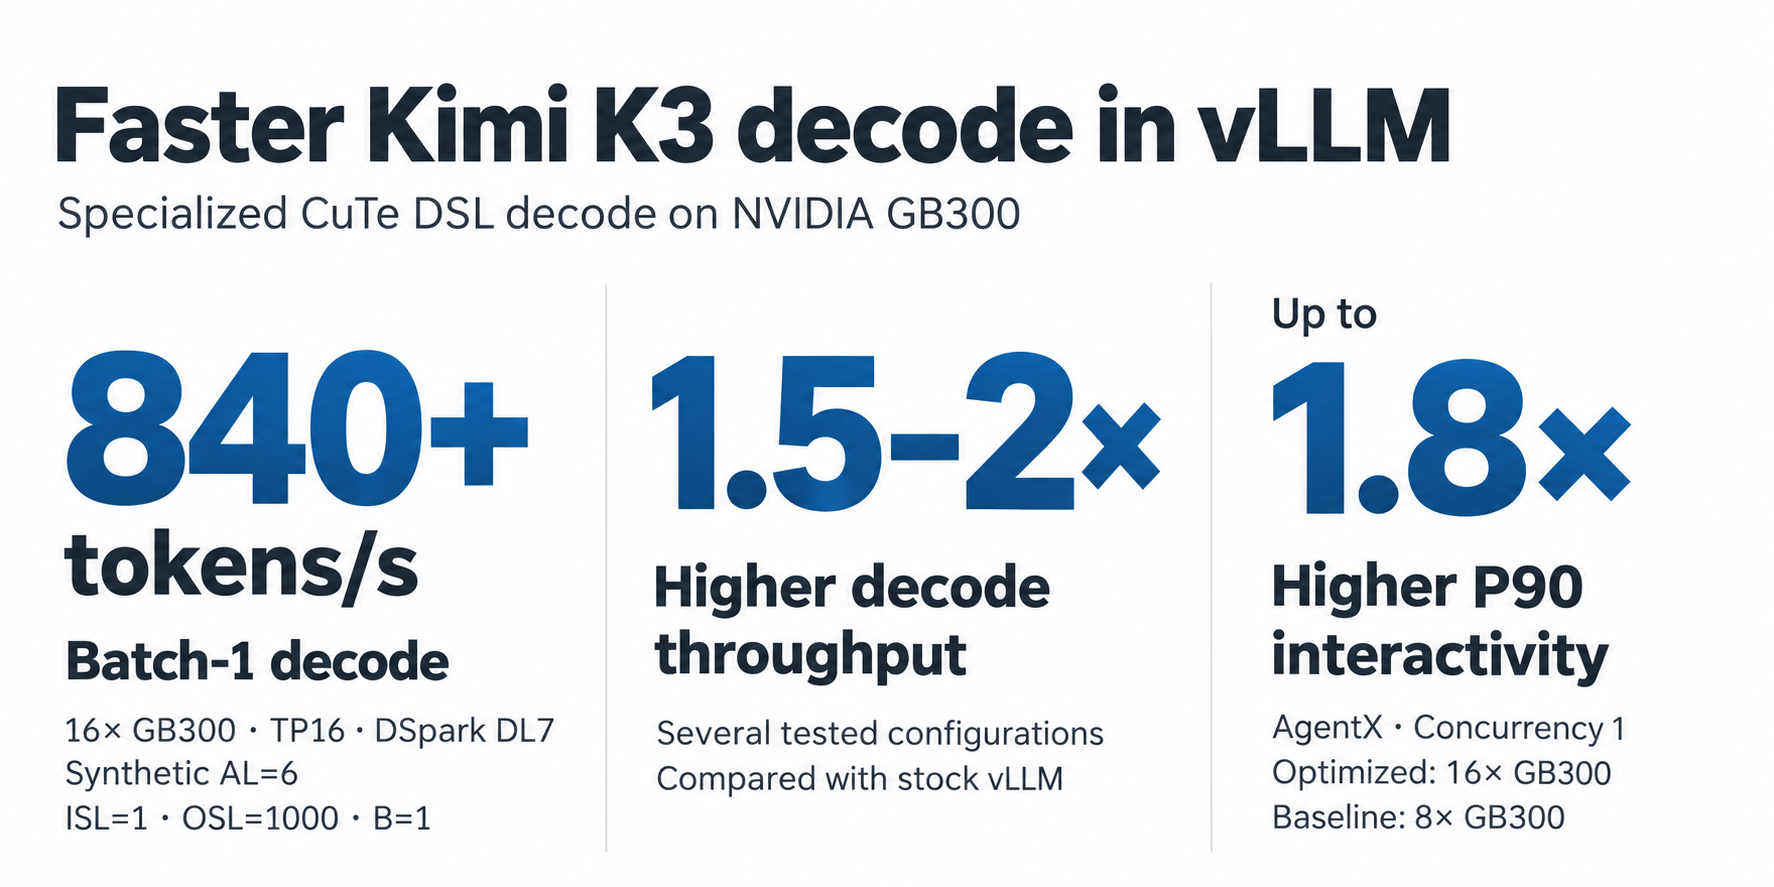
该方案在相同GB300硬件条件下实现1.68倍整体加速,同时建立了一套兼顾迭代效率与生产稳定性的模型优化工作流。
核心性能成果
本次优化面向8卡、16卡GB300多GPU部署场景,全面支持1–64解码batch,原生兼容长上下文解码、上下文并行(DCP)及DSpark推测解码等先进推理范式。
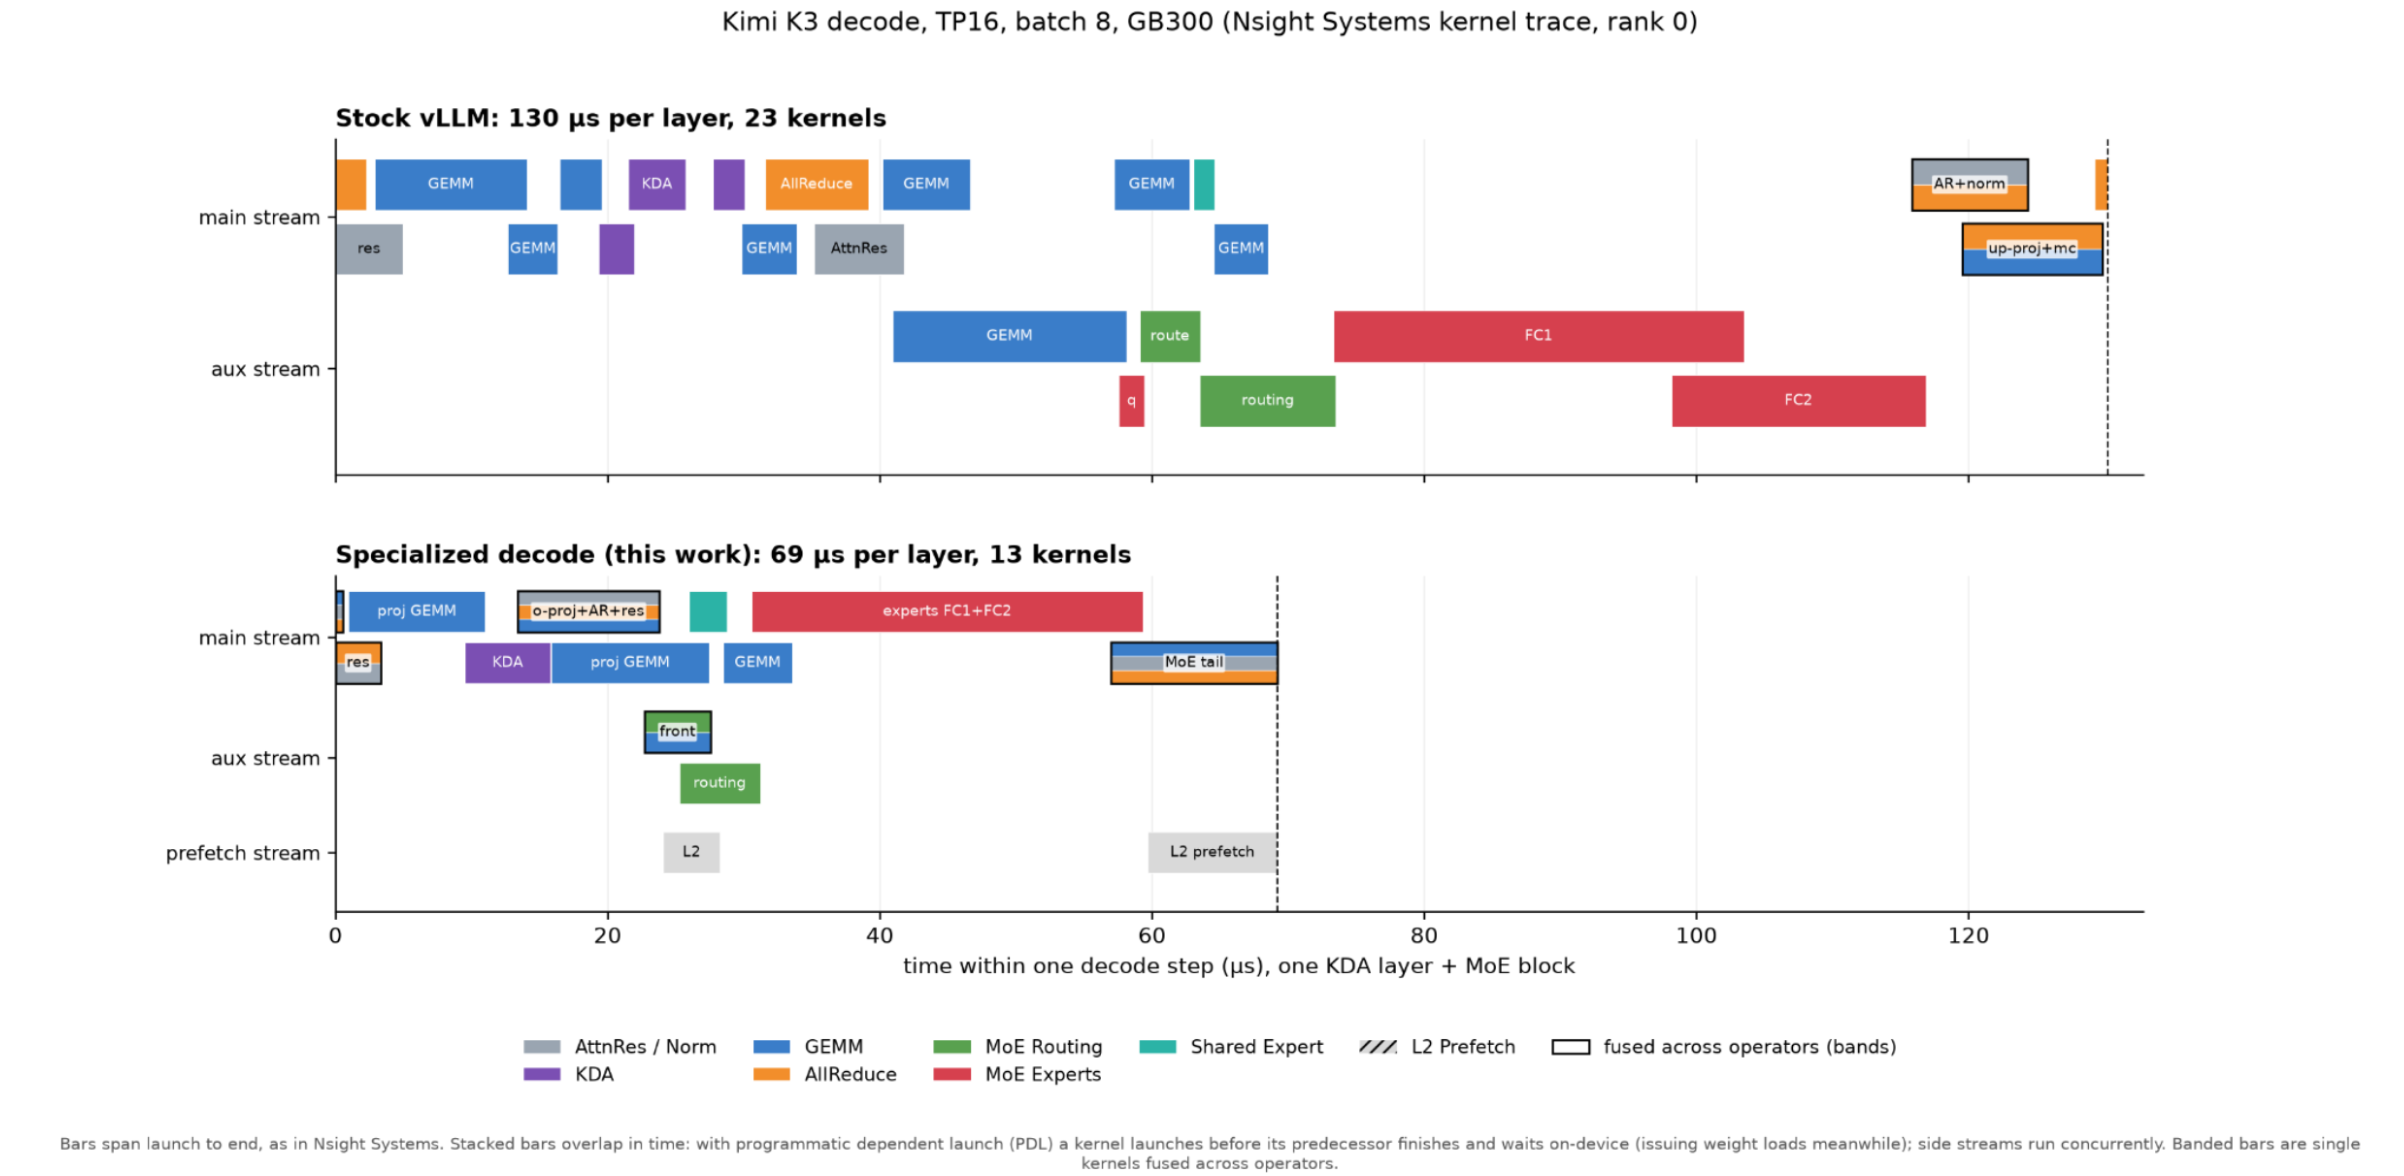
1. Batch‑1单请求解码(启用DSpark推测解码):在16张GB300环境下,解码速度达842 tokens/s,相较原版vLLM提速1.73倍;
2. 通用解码吞吐量:多种测试配置下整体吞吐提升1.5–2倍;无推测解码时,TP16在batch 1–64区间获得1.62–1.88倍加速,TP8获得1.31–1.58倍加速;
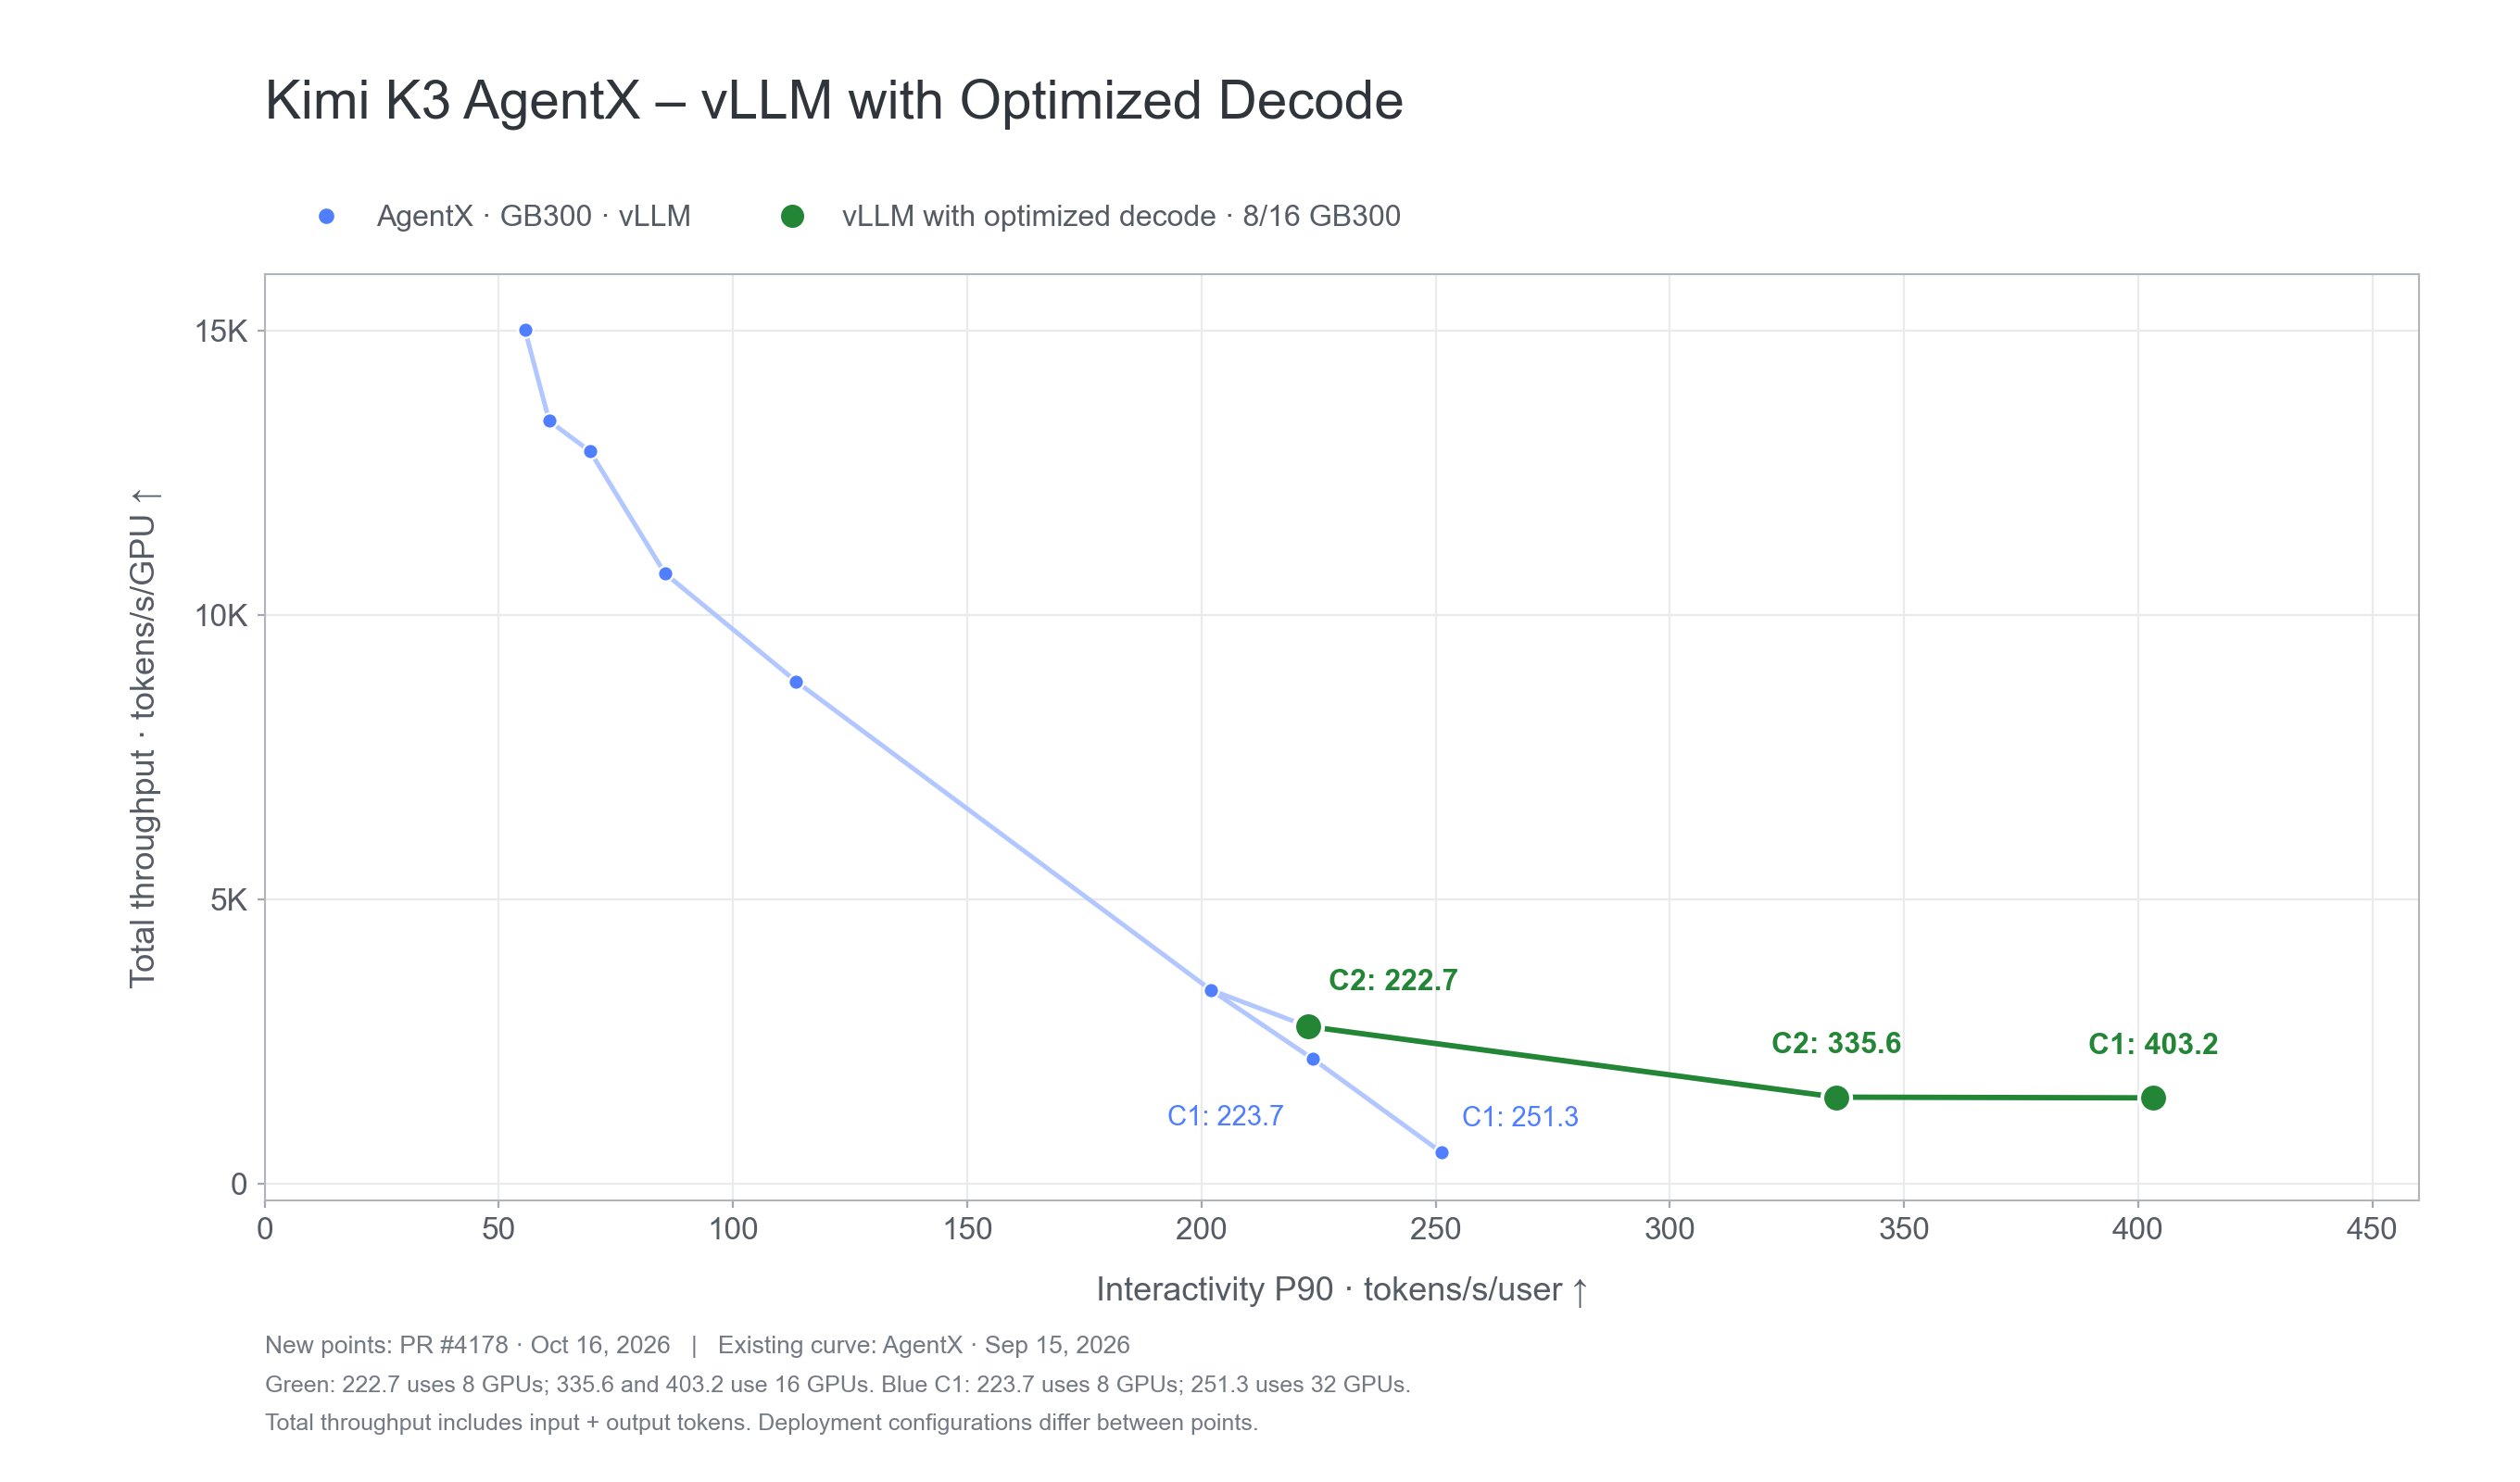
3. Agent真实业务负载(AgentX):16卡GB300部署下,P90交互性能最高提升1.8倍;单用户可达403.2 tokens/s,优于基线8卡GB300的223.7 tokens/s。
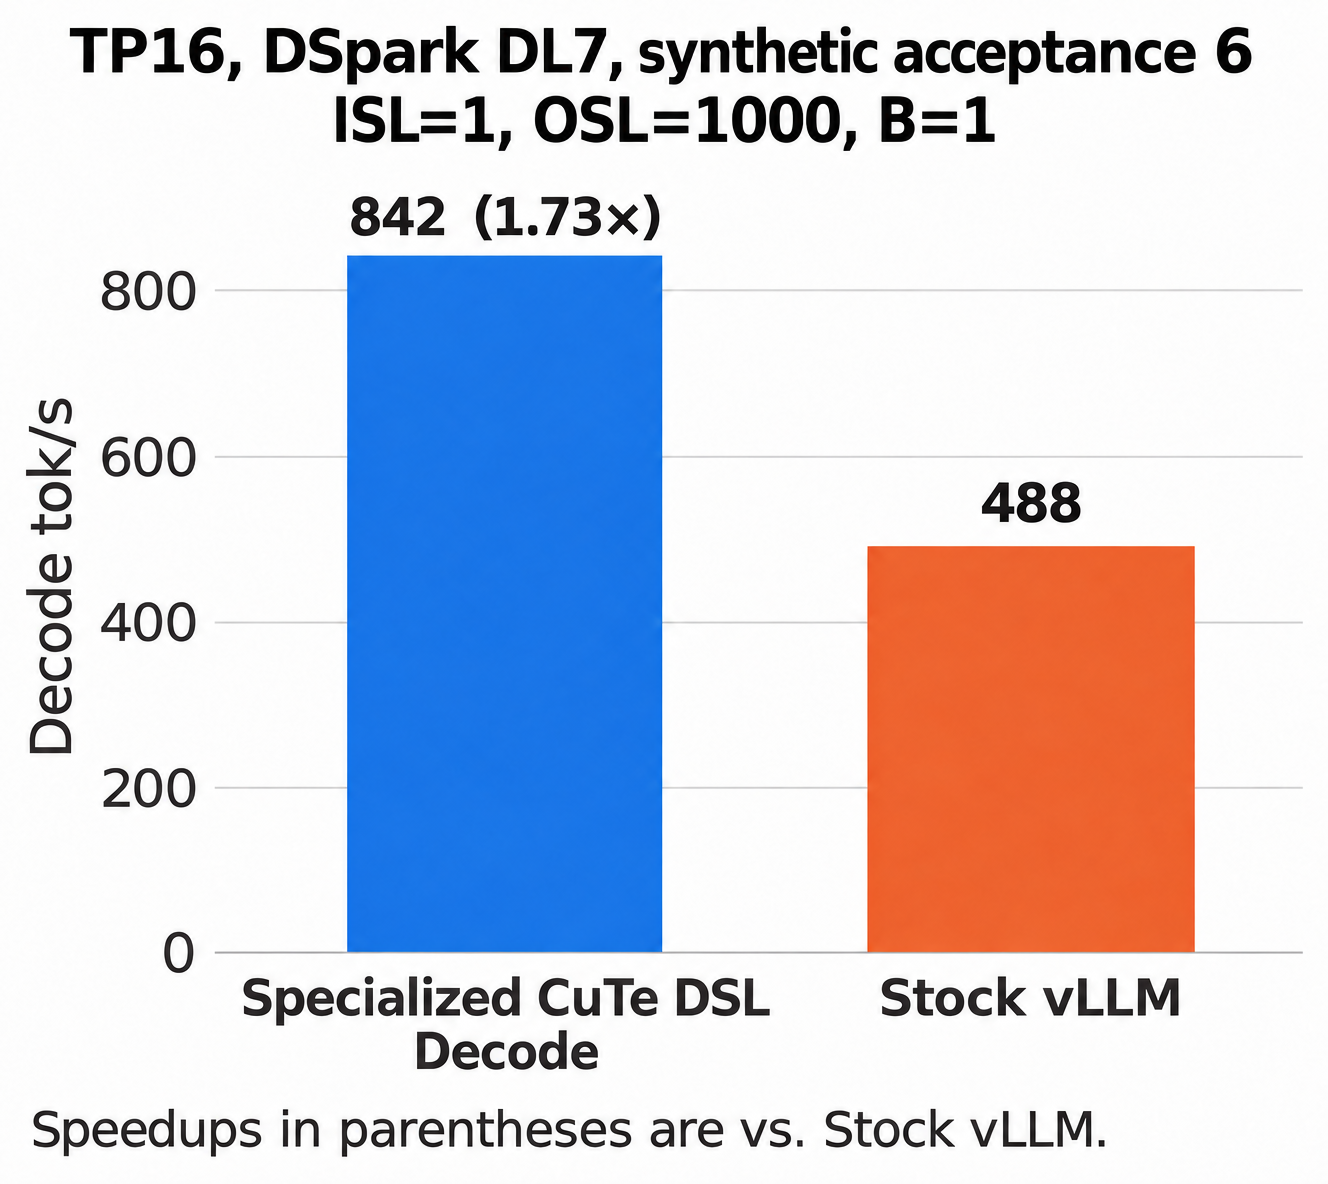
从内核执行维度看,原版vLLM每层需调用23个内核、耗时130μs;经定制优化后,每层仅需13个内核,耗时压缩至69μs,资源利用率与计算密度显著提升。
四大技术优化手段
整套优化几乎完全重构原有算子体系,全部采用CuTe DSL手写定制GPU内核,涵盖以下四项关键技术:
1. 面向业务动态适配算子形状
针对不同batch规模智能选择矩阵计算策略:小batch(1–2)启用小矩阵专用内核;大batch采用split‑K矩阵乘法;KDA注意力内核与长上下文DCP均完成定向调优,最大化释放GPU算力与访存带宽潜力。
2. 计算与通信深度重叠
融合注意力输出投影、all‑reduce规约与残差计算;GPU直接向NVLink共享缓冲区写入中间结果,接收端内核无缝接续运算;大batch采用两阶段规约机制,降低多卡间数据搬运开销,实现无同步栅栏、低开销的分布式数据交换。
3. MoE专家调度精细化并行
将路由打分与隐层输入投影拆分至各张量并行rank独立执行,再通过NVLink聚合结果,消除重复计算与权重重复加载;共享专家运行于独立CUDA流,与路由逻辑及普通专家计算并行,实现GPU资源的均衡调度与零争抢。
4. 权重预取增强缓存命中
针对小batch推理常受内存带宽制约的问题,在通信或计算空闲期,通过独立侧流内核提前预加载后续算子所需权重,大幅提升L2缓存与HBM预取命中率,有效缓解内存瓶颈。
兼顾速度与稳定性:Fast‑Track模型优化原则
文章指出当前AI工程中一个关键矛盾:Agent辅助生成内核代码的速度已远超人工审查与维护节奏——盲目上线易引发线上故障,而逐行人工审核又严重拖慢迭代周期。
为此,社区提出Fast‑Track RFC规范,确立四条核心原则,在保障快速交付的同时系统性管控风险:
1. 变更隔离:模型专属优化严格收敛于模型内部代码;运行时可动态追踪优化路径的启用与退出,不侵入vLLM全局公共模块(如KV缓存管理、采样逻辑等),避免波及其他模型部署。
2. 限定范围,不降功能:优化可限定特定硬件平台、并行方式或batch区间,但严禁阉割任何生产必备能力——长上下文支持、多样化采样策略、结构化输出等关键特性必须完整保留,并纳入全链路验证流程。
3. 系统性正确性校验:不仅执行内核级单元测试,更需覆盖端到端模型评估;所有测试必须真实触发优化后的代码路径;尤其通过长上下文、长序列生成任务暴露单元测试难以发现的数值稳定性缺陷。
4. 全场景性能回归验证:拒绝单一指标“亮点跑分”,须遍历不同batch大小、上下文长度、并行配置组合;MoE测试采用真实业务提示词;社区同步推进“自带GPU评测RFC”,鼓励贡献者在自有设备复现结果,大幅降低CI流水线对GPU资源的依赖压力。
后续规划
该套面向Kimi K3构建的优化架构已快速复用于多个主流大模型:
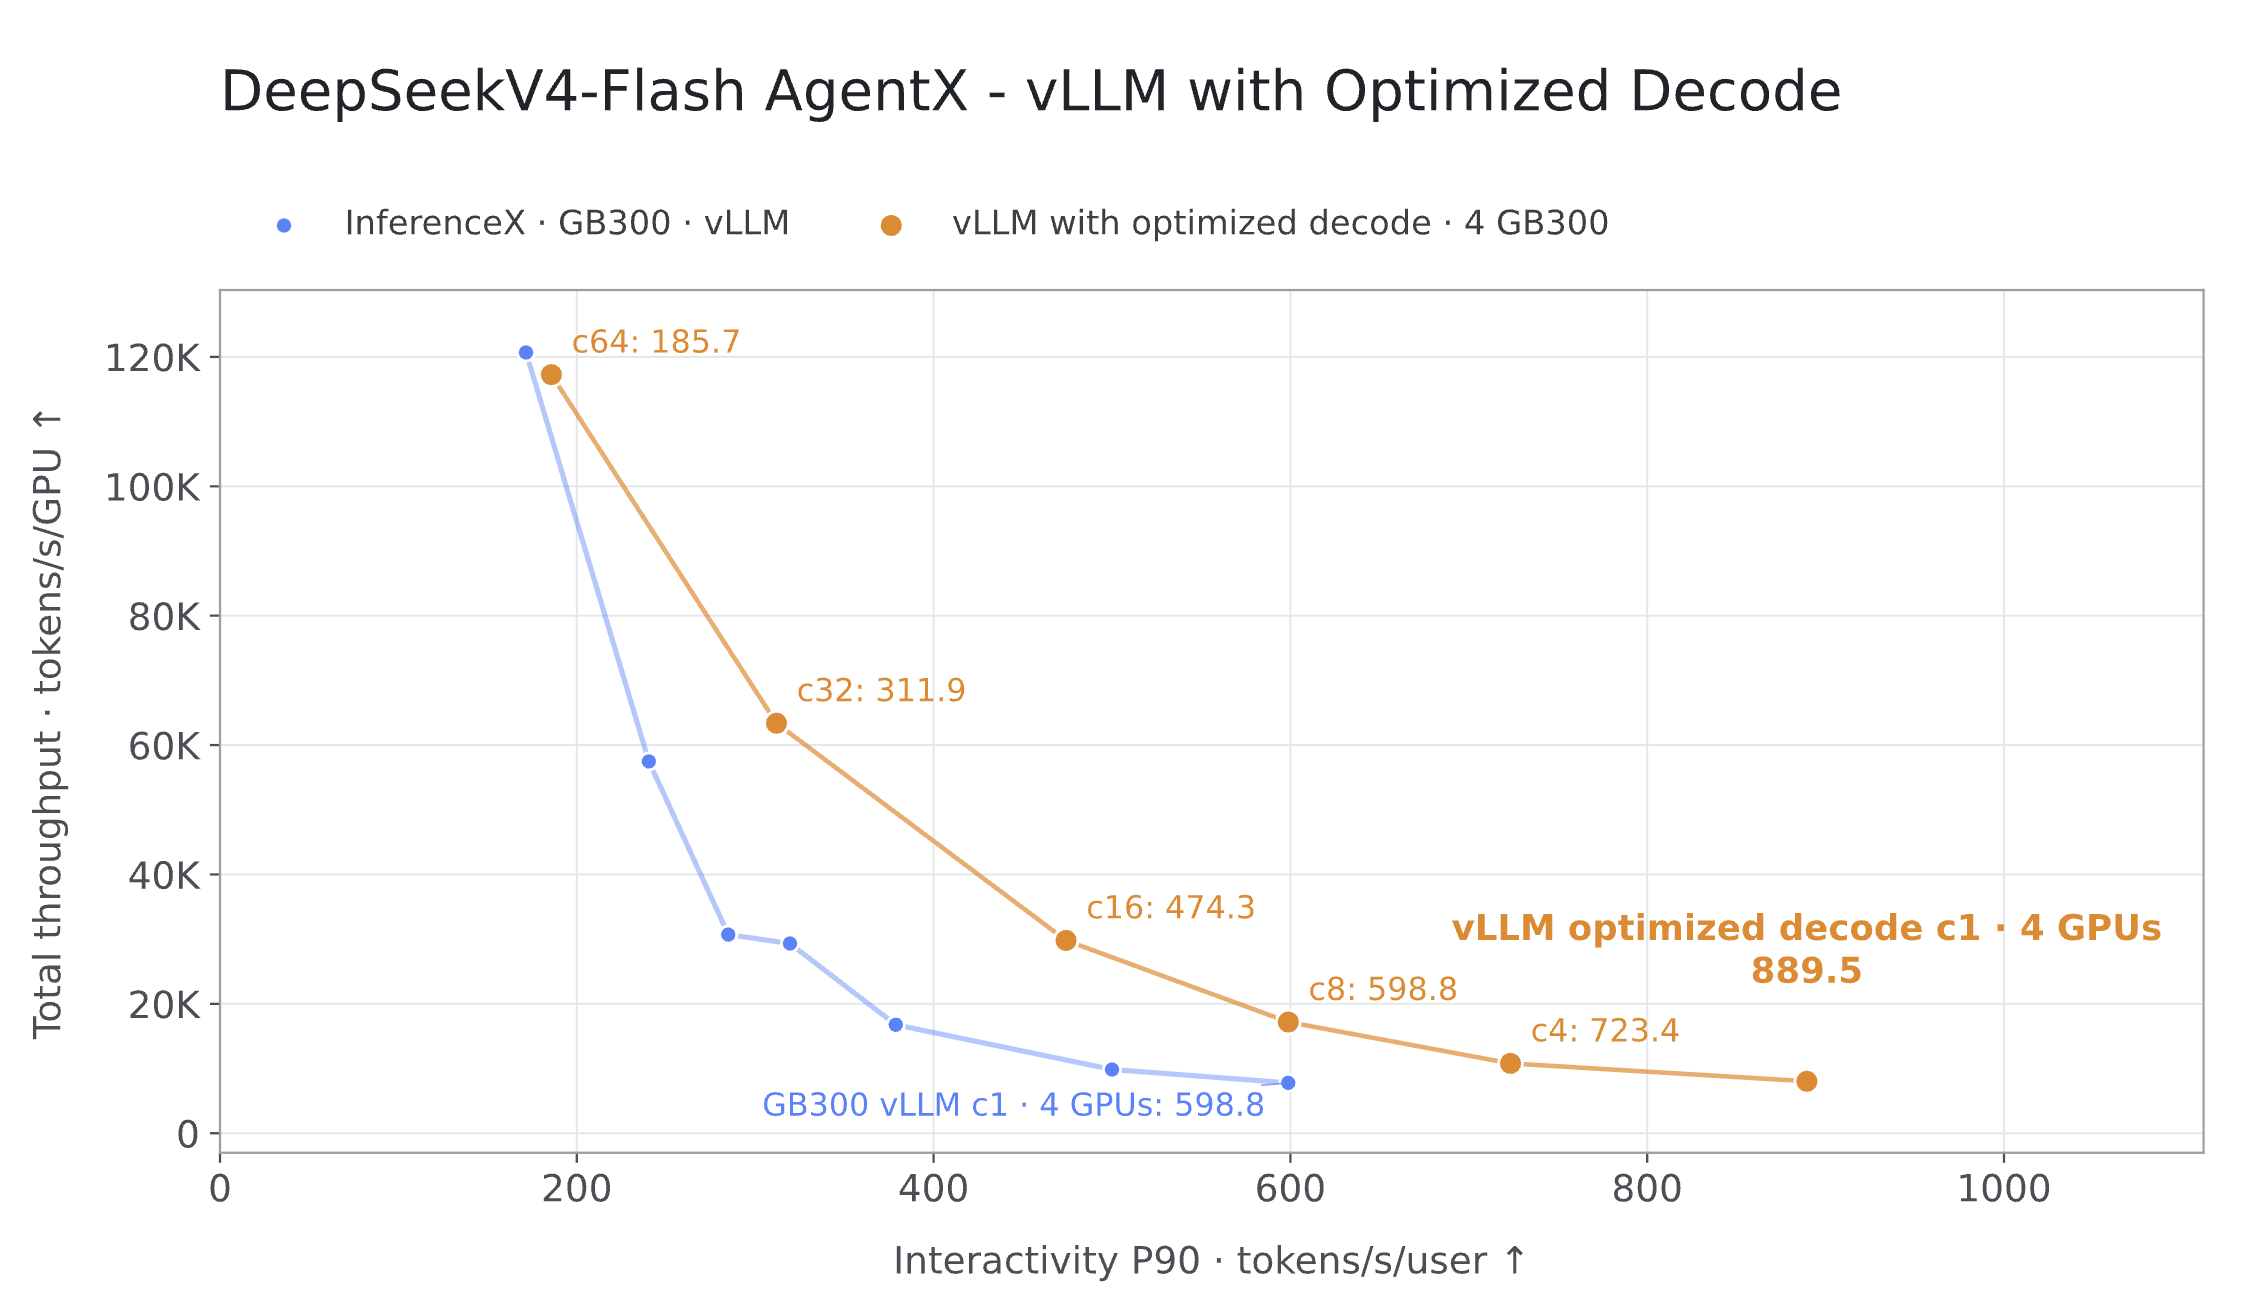
– DeepSeek‑V4.1‑Flash:复用latency_specialized解码后端,支持最高64并发请求;融合all‑reduce算子,全面替换MoE与矩阵乘内核;并将CPU侧部分逻辑迁移至CUDA Graph,进一步降低调度开销;
– Meta Muse Spark Open:已取得早期验证成果,在7个draft token推测解码模式下单用户吞吐达950 tokens/s;
– GLM5.3:正开发面向低并发场景的同类低延迟解码优化方案,相关细节与基准测试数据将在后续公开。
vLLM团队表示,将持续贯彻该工程范式:坚持真实可复现的性能收益、确保生产功能完备性、落实自动化正确性与性能验证闭环,并将Agent辅助内核优化模式规模化推广至更多大模型生态。