熵旋芯智发布首代MRAM存内计算架构MITA,瞄准AI推理能效瓶颈
撰文 | 李信马
题图 | AI制图
10月25日,熵旋芯智在其官方公众号正式发布全球首代基于MRAM(磁随机存取存储器)的存内计算架构——MITA(MRAM In-Memory Tensor Architecture),并同步定义其核心计算单元MPU(MRAM-based Processing Unit)。
该架构专为大模型AI推理场景设计,目标是显著降低数据搬运延迟、提升计算通量,并在系统级层面缓解功耗、带宽与成本等多重瓶颈。
一个月前,SmartHey与熵旋芯智创始人雷坤展开深度对话。彼时北京正值秋雨连绵,他刚结束在上海举办的AI芯片峰会,并围绕MRAM存内计算技术发表主题报告。几乎同一时间,在杭州云栖大会现场,阿里平头哥重磅发布AI芯片真武V900——性能达前代M890的三倍,216GB显存与1200GB/s片间互联成为全场焦点。
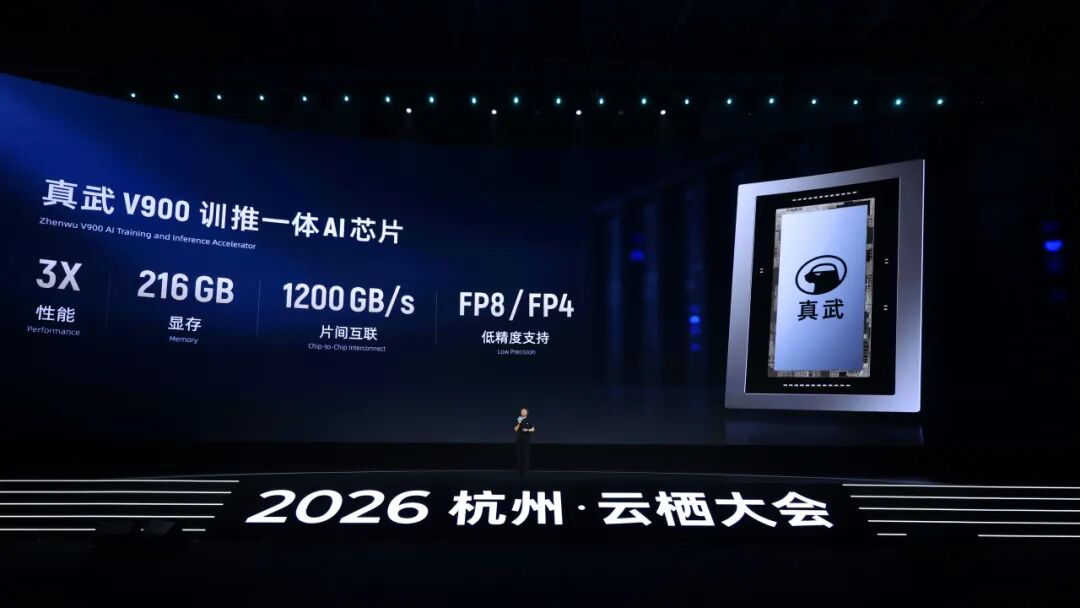
图片来源:阿里云
“超节点”一词,成为AI芯片峰会、云栖大会乃至几天前华为全联接大会的高频关键词。在行业共识中,“超节点集群”正被确立为支撑下一代AI基础设施的关键形态。
紧迫感,正从一场场发布会中弥漫开来。而当被问及技术演进的底层动因时,雷坤一语点破:“大家的终极目标一致——算力增长飞快,但数据供给已明显跟不上。”
过去几年,业界焦虑于算力不足;如今,中国日均Token消耗量已达约500万亿,AI发展的瓶颈已悄然转向更深层的系统级挑战:存储容量、数据带宽、搬运功耗及整体硬件成本。传统AI芯片普遍采用“存算分离”架构,海量模型参数需在HBM、片上缓存与计算单元之间反复调度。
在AI推理任务中,数据在“存”与“算”之间的流转效率,直接决定芯片的实际吞吐能力与能效比。随着模型规模持续膨胀,对高带宽存储的依赖加剧,随之而来的是功耗攀升与硬件成本激增。
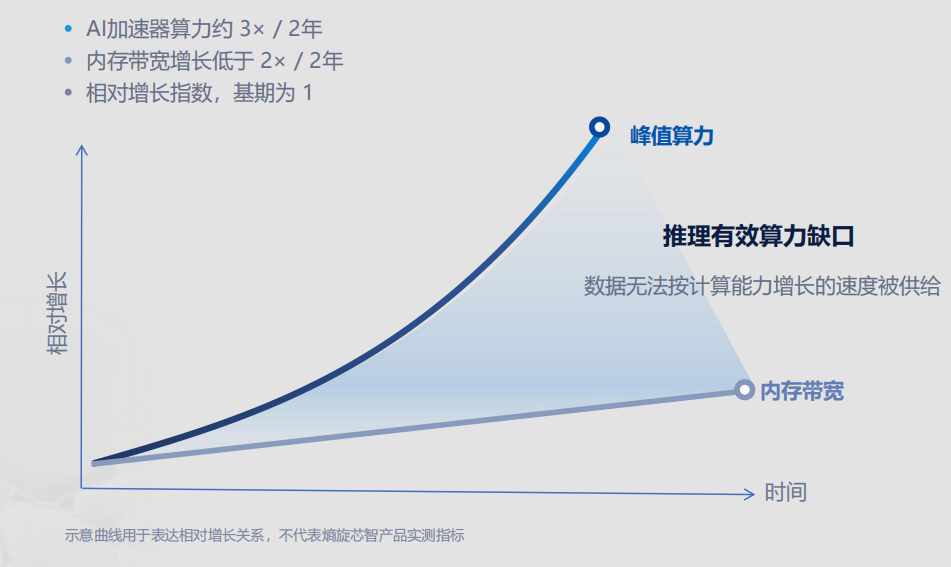
图片来源:熵旋芯智
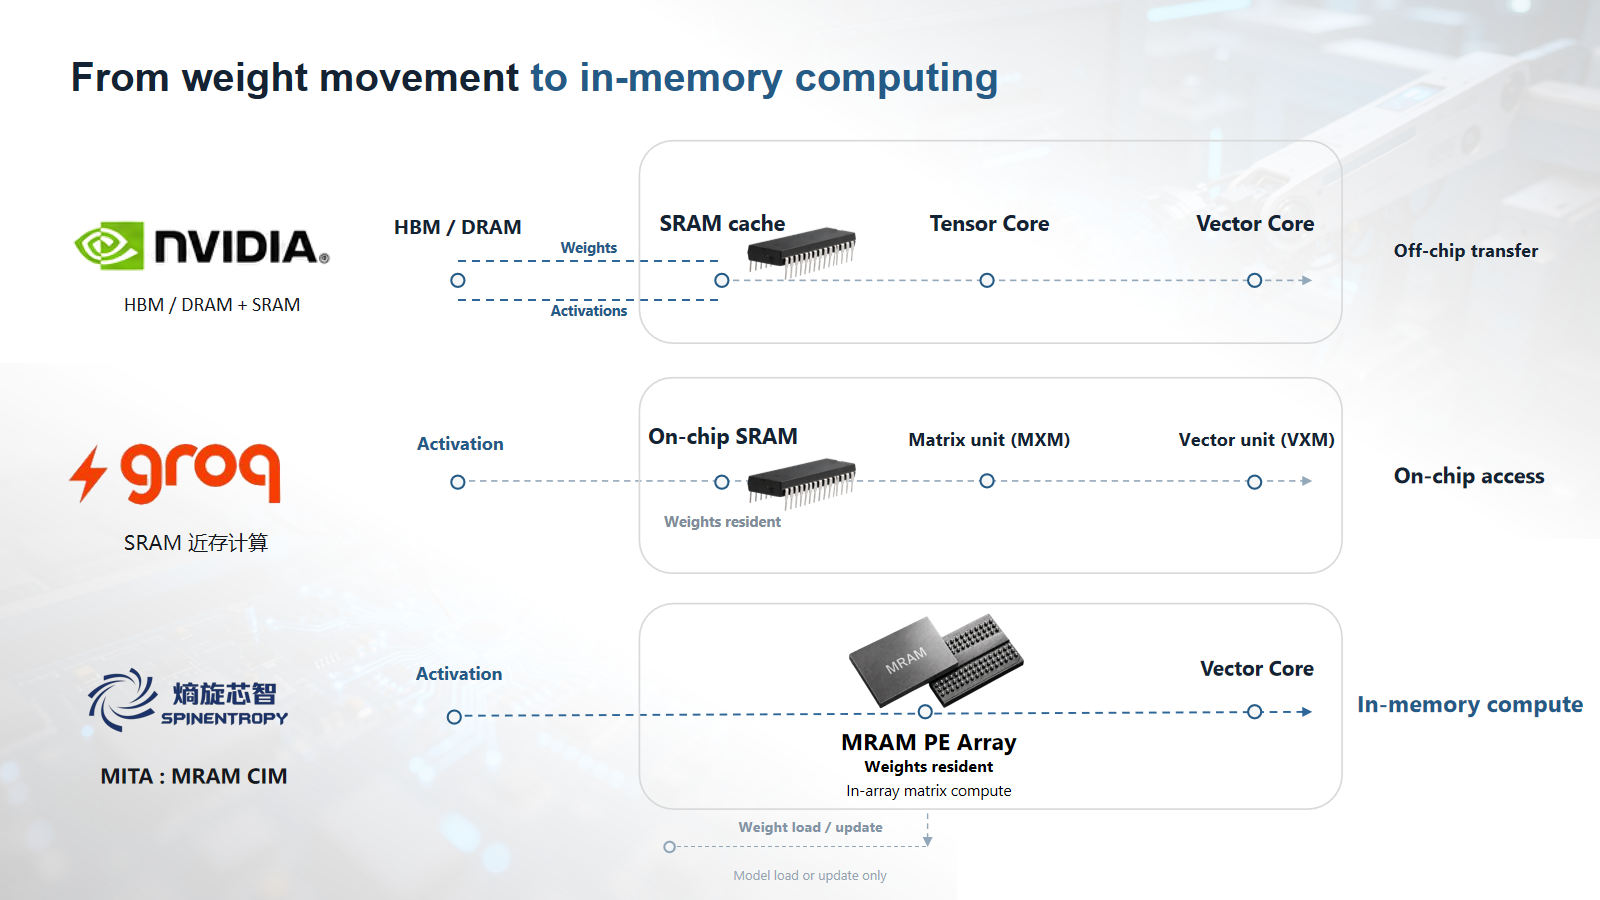
类比而言,GPU如同一座图书馆:一层是阅览室(计算单元),二至四层是书库(存储)。用户需频繁往返楼层取书、阅读、归还——以NVIDIA GPU为例,数据需穿越“片外存储→片上缓存→计算单元”的长链路,多级搬运导致延迟与功耗双双居高不下;甚至“取书时间”远超“读书时间”。
这一矛盾正日益尖锐,内存价格持续高位运行,正是供需失衡的直观体现。
科技企业正从不同路径破局:“超节点”聚焦系统级整合,而熵旋芯智选择在芯片底层另辟蹊径——以MRAM为基底,构建新一代存算一体架构。
01、搬得更快,不如不用搬
当前主流方案聚焦于“提速”与“扩容”:通过增大显存容纳更大模型,依托高速互联实现多卡协同。雷坤解释道:“显存扩容是为了‘装得下’模型;而多卡互联,则是因单卡显存有限,必须跨卡协同。但一旦分卡,通信带宽就成了关键——若带宽不足,多卡收益反而为负。”
然而,这条路正面临三重隐忧:其一,HBM带宽逼近物理极限;其二,每张卡需重复加载完整权重,造成存储冗余;其三,MoE架构中大量静态权重仍需在HBM中周期性刷新,徒增功耗。
更严峻的是,HBM供应持续紧张、价格屡创新高。谁能率先摆脱对高带宽存储的路径依赖,谁就能在下一轮算力竞争中赢得战略主动。
回溯去年12月,英伟达以170亿至200亿美元完成对Groq芯片技术的非独家授权——创下其史上最大单笔交易纪录。Groq3 LP30芯片集成500MB片上SRAM,单芯片带宽达150TB/s;其LPX机架搭载256颗LPU,总SRAM容量128GB,整体带宽高达40PB/s。该架构将模型权重常驻片上SRAM,彻底规避HBM跨芯片往返延迟。实测显示,Groq3 LPX每秒可处理约3400个Token,速度约为同类平台的4倍。英伟达明确将其定位为GPU的互补角色:GPU负责训练与通用推理,LPX专注低延迟智能体任务。
“我们的芯片设计思路与Groq高度相似,”雷坤坦言,“同样是把权重放在片上,让计算无需等待数据搬运。”
他进一步指出:“此前英伟达尚未推出Rubin架构(Vera Rubin平台,面向智能体AI与长上下文推理的下一代超级计算平台),这个方向尚难说服市场;但如今Rubin已落地,且与LPX组成混合集群并量产交付——对我们而言,技术合理性的验证成本大幅降低:既然英伟达已躬身入局,那我们坚持这条路径,就更具说服力。”
那么,为何熵旋芯智未沿用Groq的SRAM路线,而是选择更具前沿性的MRAM?
答案在于工程与能效的再平衡。根据熵旋芯智提供的技术资料,在同等制程下,MRAM bitcell面积可压缩至SRAM的约三分之一,含外围电路的完整存储阵列面积约为同容量SRAM的一半,具备2–4倍的存储密度优势。更重要的是,MRAM具备非易失特性——模型权重写入后无需供电维持,可显著降低大模型推理中的静态功耗。
此外,MRAM器件阻态变异系数(CV)低于2%,电流输出高度收敛,使阵列计算具备优异的统计一致性与可预测性,大幅降低对ADC精度与校准复杂度的要求。低离散性与稳定阻态,使其天然适配大规模、可校准的模拟存算阵列。
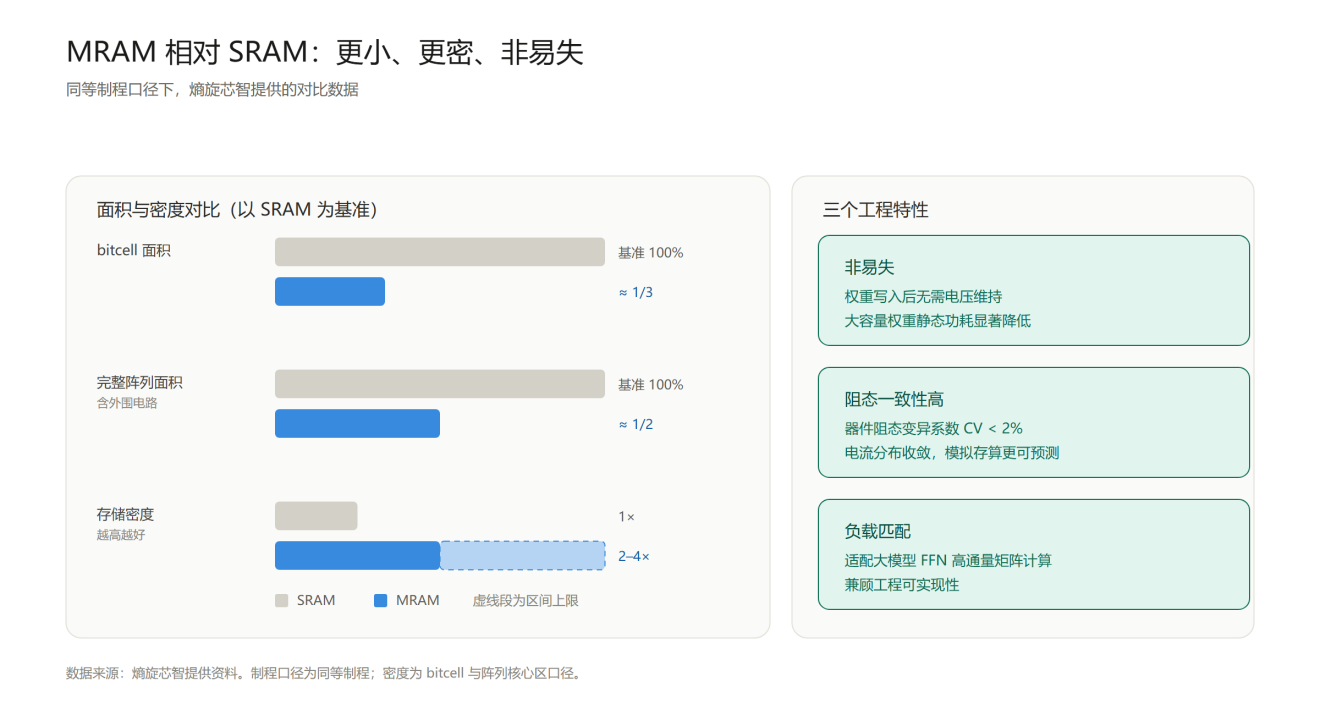
对大模型推理而言,MRAM成为一条兼顾性能匹配性与工程落地可行性的优选路径:模型参数可缓存在MRAM阵列中,矩阵运算既可在MRAM原位完成(In-Memory Compute MPU),也可由邻近数字Tensor Core执行(Near-Memory Compute MPU)。其中,纯存内MPU无需数字计算单元,可释放更多片上面积用于MRAM阵列与参数缓存;权重存储与计算同址完成,简化调度层级,通过软硬协同,有望将原位计算的物理优势转化为低延迟、高有效吞吐的系统级收益。
图片来源:熵旋芯智
02、从学术界到产业界
熵旋芯智成立于2026年2月。创始人雷坤2020年进入中科院半导体所硕博连读,2021年首次接触MRAM研究。“当时做的大多是实验室级Demo,工艺来源杂、量产性弱,属于‘手搓’阶段。”他回忆道。当他意识到阵列密度、良率与工艺偏差等关键问题超出高校科研范畴后,便决心走向产业一线。
2022年底,他进入产业界实践;2024年返京后,与导师共同组建4人小团队——成员均为清华大学实习生,其中3人后续保研至课题组,1人加入熵旋芯智成为创始成员。
创业决策源于一次严谨的“工程算账”:“做成芯片后,MRAM在密度、功耗、成本维度综合优于SRAM。”产业基础同样坚实:三星已于2019年量产28nm FD-SOI eMRAM,2026年推进至14LPU/8LPU FinFET工艺,并规划2027年延伸至5nm;台积电22nm eMRAM已量产,16nm eMRAM完成认证并进入客户导入阶段——这些进展,构成了创业的现实支点。
公司聚焦芯片设计环节,主攻云端大模型推理加速,首款产品定位于专用FFN(Feed-Forward Network)计算加速器,旨在现有GPU/AI加速器生态中承担高频、规则化矩阵计算任务。内部按数字前端、数字后端、DFT、模拟前端、模拟后端、软件算法、验证七大职能划分。
1998年出生的雷坤,在创业中快速完成角色跃迁。他将时间划分为三块:最大比重用于统一团队认知、打磨技术细节;其次投入融资、品牌传播与行业路演;最后才是非工程类团队管理。
“搞数字的不懂模拟,搞模拟的不懂NPU,搞算法的不懂硬件噪声。”他举例说明跨域协作的挑战:有模拟工程师曾深耕存储与存算,却未接触过Transformer;他需让对方理解“我们做的是Transformer的FFN模块,需要高通量、低错率”;算法工程师负责比特重建,他需阐明“数据如何生成、多少周期输出、重建策略如何设计”;架构师熟悉SRAM,他则要解释MRAM“映射完成后几个周期输出几个数”。
“团队每位成员在原有领域都是专家,但来到熵旋芯智,都要拥抱新边界——因为我们正在MRAM存算这条无人区里,做真正的先行者。”雷坤说。
相较之下,对外沟通更为顺畅。公司目前已接近完成第三轮融资,雷坤表示资金储备“较为充足,足以支撑至芯片量产阶段”。投资方亦积极协助对接产业链资源,尽管这属于中长期过程。值得一提的是,2026年9月15日发布的《电子信息制造业发展“十五五”规划》明确提出“加快存算一体技术攻关”与“突破新型存储技术”,为融资进程提供了政策背书。
客户拓展则更具挑战性。雷坤直言:“融资看的是逻辑与国家战略契合度,客户却只认结果——芯片尚未回片,不可能仅凭概念买单,最终必须落在PPA(功耗、性能、面积)的硬指标上。”
而这一切,都需要时间。“后来者必须经历多次流片迭代,这是无法绕开的工程规律。”当被问及当前最大困难时,雷坤稍作停顿后回答:“本质上不是技术卡点,而是时间。流片周期、与晶圆厂协同、回片测试验证……这些都不是不可逾越的障碍,但它们都消耗时间,也消耗资金。”
在他看来,当下行业的“芯片热”与“内存热”,反映的是对短期高确定性回报的追逐;而熵旋芯智选择向前一步,押注下一个十年更具爆发力的技术拐点。“也许,那不只是200亿美元的未来。”他计划中的首款芯片将于2027年3月启动流片,6月完成回片验证。在此之前,AI带来的狂热与焦虑,仍将持续席卷整个世界。